
2025 年 7 月、1 時間の会議録音の処理には 26.8 分 かかっていました。
今月、同じジョブは 4.9 分 で終わります。
見栄えのために用意したベンチマークではありません。それぞれの 7 月に処理した「1 時間の会議」すべての処理時間の中央値で、選りすぐりのデモファイルではなく、失敗したジョブは両側から除外しています。同じ月、同じファイル長、同じ測定方法。およそ 5.5 倍の高速化です — そして長いファイルほど伸びはさらに大きくなっています。
「高速化リリース」を出したわけではありません。誰もブログに書かないパイプラインの地味な部分を 1 年かけて改善し続けた結果が、積み重なったものです。
実際に何が変わったか
2025 年 7 月と 2026 年 7 月の処理時間の中央値です。各セルの 2 つ目の数字は遅い側の 1 割 — 10 件に 1 件の最も遅いジョブの水準です。中央値は数字を良く見せます。最悪の日がどうなるかを教えてくれるのはテール側です。
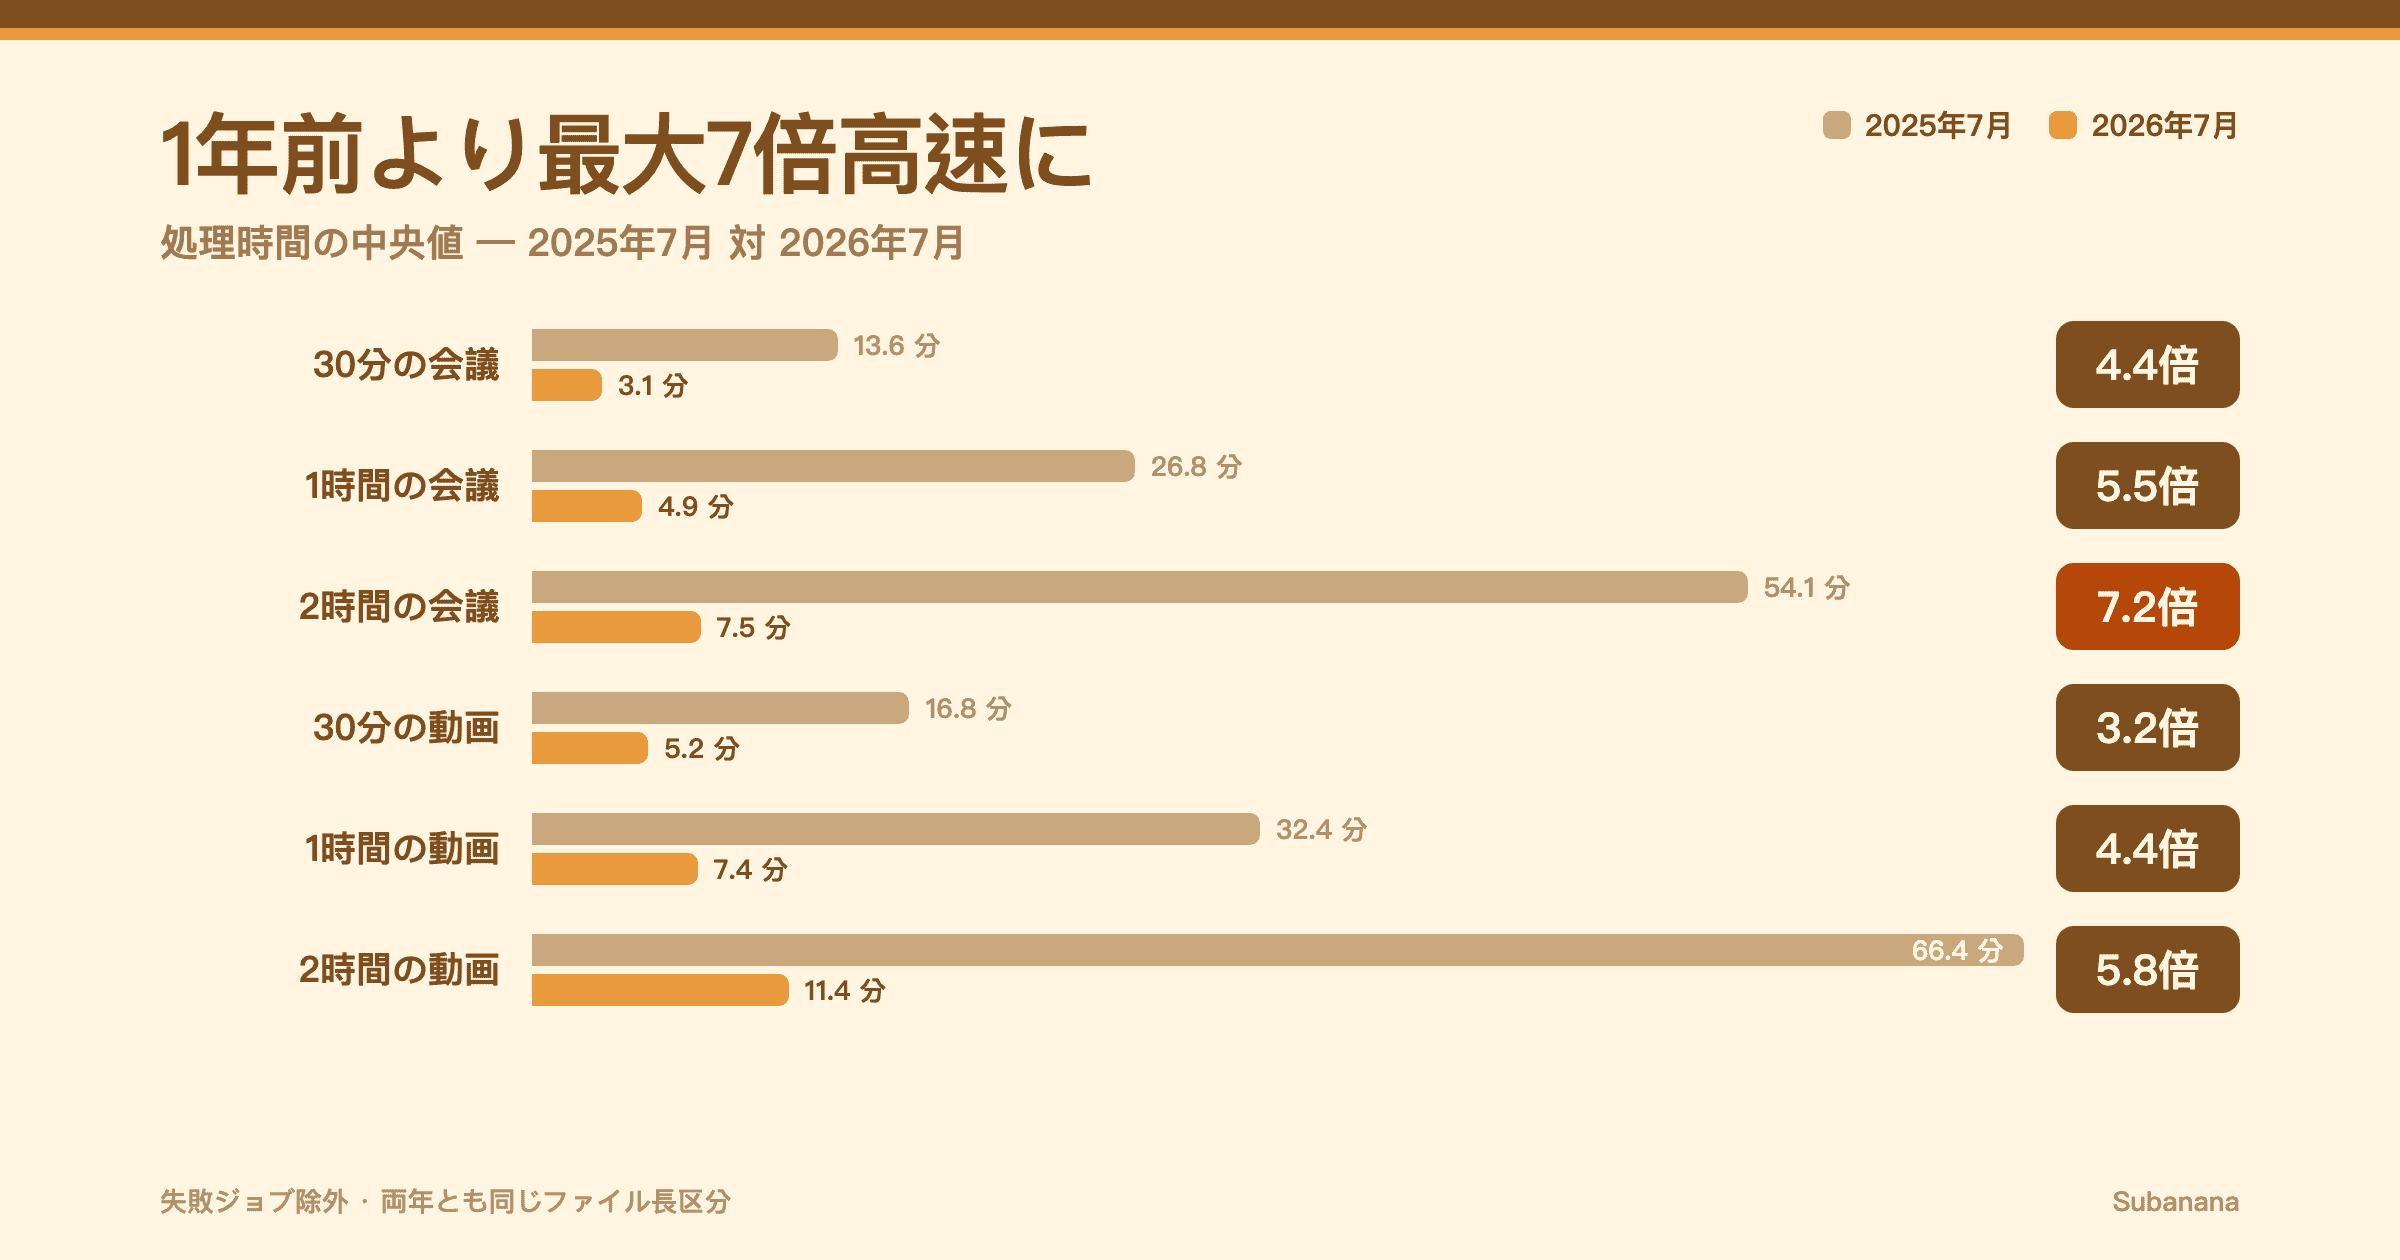
| ジョブ | 2025 年 7 月 | 2026 年 7 月 | 高速化 |
|---|---|---|---|
| 30 分の会議 | 13.6 分 (p90 26.4) | 3.1 分 (p90 5.9) | 4.4 倍 |
| 1 時間の会議 | 26.8 分 (p90 61.9) | 4.9 分 (p90 6.8) | 5.5 倍 |
| 2 時間の会議 | 54.1 分 (p90 120.9) | 7.5 分 (p90 13.4) | 7.2 倍 |
| 30 分の動画 | 16.8 分 (p90 35.6) | 5.2 分 (p90 12.1) | 3.2 倍 |
| 1 時間の動画 | 32.4 分 (p90 136.4) | 7.4 分 (p90 21.0) | 4.4 倍 |
| 2 時間の動画 | 66.4 分 (p90 147.3) | 11.4 分 (p90 28.9) | 5.8 倍 |
テールは中央値以上に改善しており、こちらのほうが重要です。1 年前は、1 時間の会議 10 件のうち 1 件は戻ってくるまでに 1 時間以上かかっていました。いまは遅い側の 1 割でも 7 分からです — 今日の遅いジョブは、当時の普通のジョブより数倍速いのです。1 時間動画の最悪ケースは 2 時間超から 21 分になりました。Subanana のためにスケジュールへこっそり余裕を入れていたなら、もうやめて大丈夫です。
長いファイルほど改善幅が大きくなっています — 7 倍は「2 時間の会議」の行にあります。短いデモクリップに合わせてチューニングされた一般的なパイプラインとは逆の結果で、この違いは使い方を変えます。1 時間半の待ちは「昼食後に戻ってくる」ジョブですが、7 分なら「席で待つ」ジョブです。
そして伸びは止まっていません。7 月最終週は Subanana 史上最速の 1 週間で、1 時間動画の中央値は 5.5 分でした。
意外だった部分
今日、1 時間の動画の待ち時間がどう分かれているかです。各ステージは重なり合うため、厳密な順序ではなく、おおよその割合として見てください。
| ステージ | 待ち時間に占める割合 |
|---|---|
| キュー待ち | 約 7% |
| ファイルのパイプライン投入 | 約 2% |
| メディア準備(音声・波形) | 約 25% |
| 文字起こし | 約 20% |
| 字幕キューの生成と検証 | 約 16% |
| スクラブ用プレビューのレンダリング | 約 29% |
文字起こし — AI の部分 — は待ち時間の約 5 分の 1 に過ぎません。
AI がボトルネックだったことは一度もありません。誰もが音声認識が最も遅い工程だと思い込みます。モデルが入っている工程だからです。しかし実際には違い、しかもかなり前から違います。待ち時間のおよそ 5 分の 4 は裏方作業です。ファイルのデコード、クリーンな音声トラックの抽出、波形の生成、あとで結果をスクラブして確認するためにエディタが必要とするプレビューのレンダリング。
だからこそ、改善はそこから来ました。ファイルの投入だけでも 6 月から 90% 以上速くなり、メディア準備はおよそ半分になりました。文字起こし自体に稼げる余地はほとんどなく、それ以外のすべてに大きな余地があったのです。
この表から、知っておくと役立つことが 3 つ導けます。
会議が最も速く戻ってきます。 会議ジョブは動画プレビューのレンダリングを完全にスキップします。同じ長さなら会議の行が動画の行より常に速い主な理由です。
翻訳を追加しても結果は遅くなりません。 翻訳は非同期で実行されます — 元言語の文字起こしと字幕はこれまでどおり最速で届き、翻訳済みトラックは後から自動的に現れます。処理速度を守るために翻訳ターゲットを外していたなら、その必要はありません。字幕モードでは 1 つのジョブに複数のターゲットを追加できます。
アップロード時間はこの数字に含まれません。 計測はファイル到着後、処理開始から始まります。回線が遅い場合、アップロードが待ち時間の大半を占めることもあります。動画が公開されているなら、YouTube・Instagram・Facebook のリンクを貼るだけでアップロードを省けます — Subanana が直接取得します。
近道できない部分
優れた音声認識モデルは誰でも借りられます。これがこのカテゴリの公然の秘密です — 最も神秘的に見える AI の部分は、API キーを申し込めば誰でも使えます。毎週のように新しい文字起こしアプリが現れるのはそのためです。
しかしモデルは待ち時間の 5 分の 1 に過ぎません。残りの 5 分の 4 はモデルを取り巻く機構です。取り込み、デコード、音声抽出、字幕生成、プレビューのレンダリング、キュー管理。どれも借りることはできません。自分で作り、実ワークロードで測定し、作り直すしかありません — そしてそれが速くなる唯一の方法は、デモでは決して表面化しない問題にエンジニアリングの時間を注ぐことです。
この 1 年に実際に起きたのは、まさにそれです。1 つの大型リリースでも、幸運なモデル乗り換えでもありません。高速化はこの 1 年半、ほぼ毎月積み重なってきました。週末に組み立てたラッパーアプリでも文字起こしは同じものを使えます。しかし 5 分の 4 は真似できません — 長いファイルをアップロードするたびに体感するのは、その 5 分の 4 です。
変わらない部分
リトライは引き続き無料です。文字起こしの結果に問題がありそうな場合、システムは該当セグメントを裏側で自動的に別のモデルに回して処理し直します。通知はありません。2 回目の処理に課金されることもなく、内部で何回リトライされてもファイル 1 つ分の料金だけです。1 年前も今もそうで、ただ速くなっただけです。
上限は引き上げられ、ファイルあたり 8 時間・30 GB になりました(無料プランは先頭15分のみ文字起こし)。実際に先に当たるのは 8 時間の上限です。
長い録音で試してみてください
2 時間の録音を「1 時間待ちたくない」と後回しにしていたなら、その計算はもう変わりました。いまは約 11 分です。
AI 会議文字起こし と AI 字幕 は、どちらもこの数字を生んだ同じパイプラインで動いています。
数値はすべて処理時間の中央値です — 2025 年 7 月(1 か月分)対 2026 年 7 月 1〜27 日 — ソースの長さでグループ化し、失敗ジョブを除外、処理開始から計測。「2 時間」の行は 90 分〜3 時間のファイルを含みます。実際の時間はファイルサイズ・コーデック・負荷により変わります。