
把訪談或會議錄音轉成逐字稿,轉完之後常常剩下一個問題:分不出誰說了哪句。要讓逐字稿可以直接拿來整理會議記錄、引用受訪者的話,需要的是「語者分離」(speaker diarization):由系統根據聲音特徵,把內容標成「語者 A:⋯⋯」「語者 B:⋯⋯」。
這篇文章解釋語者分離的原理、什麼情況容易分錯、怎樣錄音可以更準,以及三條實際路線的取捨。文末示範的 Subanana 是我經營的產品,哪些情況它不適合,我也會寫清楚。
語者分離與語音轉文字是兩件事
- 語音轉文字(STT)處理「說了什麼」:把聲音變成文字。
- 語者分離(diarization)處理「誰在何時說」:根據聲音特徵,偵測語者切換的位置,把每段聲音歸給不同語者。
根據 Google Cloud 的語音辨識文件,語者分離是辨識請求中一個獨立的參數:系統偵測語者何時切換,並用編號標記音檔中偵測到的每一個聲音。也就是說,這是疊在轉文字之上的另一層處理;兩層都做好,才會得到「按人分段」的逐字稿。
訪談逐字稿、會議記錄、多人 Podcast:只要錄音裡有兩個人以上,有沒有語者分離,可用性差非常多。
什麼情況容易分錯?
語者分離不是萬能,以下情況最容易出現「語者張冠李戴」或「一個人被拆成兩個」:
- 發言重疊。附和、插話多,語者邊界就模糊。
- 聲音相近。同性別、年紀相近的語者,聲音特徵接近,較難區分。
- 雜音多、收音遠。一支手機收整個會議室的聲音,遠處語者的分離效果一定差。
- 壓縮音源。電話錄音、線上會議的壓縮音訊,聲音特徵的線索本身就變少。
反過來說,錄音品質愈好,語者分離愈準:每人一支麥克風、環境安靜、主持人控制輪流發言,結果會明顯改善。另外,多數工具支援預先指定語者人數,知道確切人數時手動指定,通常比全自動更穩定。
三條路線:雲端 AI、本機組合、專用設備
1. 雲端 AI 逐字稿工具(方便、自動)
瀏覽器上傳檔案,轉文字與語者分離一次自動完成,不用安裝任何東西。多數工具連標點、分段、摘要都一併處理,適合想直接得到可用成品的人。代價是檔案需要上傳到雲端處理。
2. 本機 Whisper+pyannote(免費、技術門檻高)
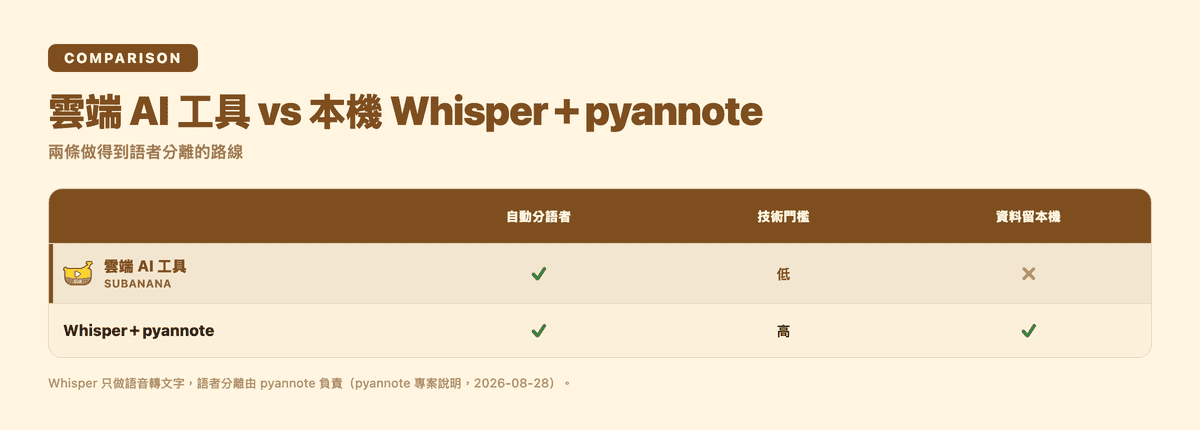
想零成本、或者資料不能離開自己電腦,可以在本機跑開源模型。要注意:OpenAI 的 Whisper 只做語音轉文字,本身不做語者分離。開源社群的標準做法是搭配 pyannote。根據 pyannote 專案說明(2026 年 8 月 28 日查閱),這個開源工具包的功能正是語者分離:偵測語音活動、語者切換、重疊發言,再把各段聲音歸類。兩者搭配,就是「先分人、再逐段轉文字」的兩步流程。
- 適合:懂 Python、願意處理環境設定,而且在乎資料留在本機的人。
- 代價:模型下載、GPU、指令操作都要自己來;中文的效果也要自己測試。
3. 專用錄音設備
實體會議可以用專門的錄音硬體收高品質音源,再交給軟體處理。適合常開實體會議的團隊,但要先購買設備。
用 Subanana 做語者分離逐字稿
Subanana 屬於第一條路線:瀏覽器完成、自動分語者。步驟如下:
- 上傳錄音或影片檔(每個檔案上限 30 GB 或 8 小時),或貼上公開的 YouTube、Instagram、Facebook 連結。
- 選擇來源語言。系統為每種語言持續評測多個辨識模型,自動挑選該語言表現最好的一個,支援語言共 95 種以上,中英夾雜的內容也處理得來。
- 設定語者人數:自動偵測或手動指定都可以。
- 轉錄完成後,逐字稿已按語者分段,並自動加標點、分段落。把「語者 1」「語者 2」改成實際姓名,讀起來就像正式記錄。
- 需要會議摘要的話,同一份轉錄可以直接生成重點、決議與行動項目,摘要用的 AI 模型可以自選,並有超過 30 個內建模板。
轉錄完成後花一兩分鐘掃一次語者標籤,有錯手動改正,是提升成品品質報酬率最高的一步。免費方案可以預覽每個檔案前 15 分鐘的結果,先用一段短錄音試試分離效果最實際;想直接在網頁上試,可以用免費 AI 逐字稿工具頁。匯出(SRT、VTT、TXT、DOCX、XLSX、Markdown)屬付費功能,方案價格見方案費用頁,Lite 年繳約 US$9/月。
Subanana 不適合的情況:資料完全不能上雲端的場景,本機 Whisper+pyannote 組合才是正路;純粹想把實體會議錄得更清楚,先解決收音硬體更實際。
常見問題
語者分離是什麼? 根據聲音特徵,標出錄音中「誰」在「何時」發言的處理;搭配語音轉文字,就得到按語者分段的逐字稿。轉文字處理「說了什麼」,語者分離處理「誰說的」,兩者是獨立的步驟。
怎樣提高語者分離的準確度? 錄音品質最關鍵:每人一支麥克風、環境安靜、減少插話,以及預先指定語者人數。完成後再花一兩分鐘核對語者標籤,成品就穩妥得多。
Whisper 可以做語者分離嗎? Whisper 本身只做語音轉文字,不做語者分離。本機方案需要搭配 pyannote 之類的開源工具包,由它負責偵測語者切換再分段。不想處理技術設定的話,用內建語者分離的雲端工具直接得多。
訪談逐字稿也適用同一套做法嗎? 適用。訪談通常只有兩三位語者,手動指定人數後分離效果更穩;完整流程可以參考訪談逐字稿教學,Podcast 節目則見 Podcast 逐字稿製作教學。