
文字起こしAIの「高精度」をどう確かめる?購入前に見るべき5つのポイント
「高精度」という言葉だけでツールを選ぶのは避けたほうがいいです。確認すべきは、公開されているベンチマークが何を測り、何を見逃すかを知ったうえで、自分の音声で仕上がりを試すことです。私はSubananaというAI文字起こしサービスを運営しています。
文字起こしさん、Rimo Voice、PLAUDをはじめ、文字起こしAIや議事録AIの多くは「高精度」と説明しています。それ自体はサービス選びの入口になりますが、どの音声で測ったのか、何を基準にしたのかまでは、たいてい説明されていません。
確認すべきなのは、ベンダーが選んだ条件のよい音声での評価ではなく、あなたが実際に使う音声での仕上がりです。この記事では、公開されている音声認識の評価方法をもとに、契約前に確認したいポイントを整理します。
公開ベンチマークは、どんな音声で測られているか
これは推測ではなく、公開されている情報から確認できます。
音声認識の研究で最も引用される音声データセットの一つ、LibriSpeechは、自身を「約1,000時間の読み上げ英語音声」のコーパスと説明しており、そのデータはLibriVoxプロジェクトの朗読オーディオブックから作られています(LibriSpeech ASR corpus、英語ページ)。一人が原稿を見ながら、静かな環境で読み上げた音声という意味です。
多言語のベンチマークも同様です。多くのモデルが多言語性能の根拠として引用するFLEURSは、論文の要旨で「機械翻訳ベンチマークFLoRes-101をもとに構築された、102言語にわたる並列音声データセットで、言語あたり約12時間の音声を含む」と説明しています(FLEURS論文、arXiv、英語ページ)。翻訳評価用の文章を読み上げて作られた、言語ごとに12時間ほどのデータということです。
つまり、多くの公開スコアは「読み上げられた、条件のよい音声」の上で測られています。誰かが嘘をついているわけではありません。ただ、その数字が測っている音声と、あなたが持っている会議録音やインタビュー音声は、そもそも別の条件だということです。
WERは何を数え、何を見逃すか
音声認識の精度を測る業界標準の指標に、単語誤り率(WER)があります。Microsoftの音声サービス公式ドキュメントは、この指標を次のように定義しています。
モデルの正確性を測定するための業界標準は、"ワード エラー率"(WER)です。WERでは、認識中に識別された誤った単語の数を数え、その合計を、人間によってラベル付けされた文字起こしで提供された単語の総数(N)で除算します。 (Custom Speech モデルの正確性をテストする — Microsoft Learn、日本語ページ)
誤りは3種類に分類されます。
- 挿入(I):仮説トランスクリプトに誤って追加された単語
- 削除(D):仮説トランスクリプトで検出されなかった単語
- 置き換え(S):参照トランスクリプトと仮説トランスクリプトの間で置き換えられた単語
この3つは同じ重みで合計され、単語の総数で割られます。ここに、この指標の限界があります。助詞が一つ抜けたことと、会社名が別の名前に置き換わったことが、同じ「1件」として数えられるのです。会議録として見たとき、前者はほとんど気づかれず、後者は資料として使えなくなります。それでもスコアは同じです。
同じドキュメントは、誤りの傾向についても説明しています。
多くの削除エラーが発生した場合は、通常、オーディオ信号の強度が弱いためです。…挿入エラーは、オーディオがノイズの多い環境で録音され、クロストークが存在し、認識の問題が発生する可能性があることを意味します。置換エラーは、ドメイン固有の用語のサンプルが、ヒューマン ラベル付け文字起こしまたは関連テキストとして十分に提供されていない場合にしばしば発生します。 (同上、Microsoft Learn 日本語ページ)
日本語の業務音声に置き換えると、この3行がそのまま診断表になります。声が遠い参加者が多いと削除エラーが、複数人が同時に話すと挿入エラーが、社内用語や英語の製品名が多いと置換エラーが増えます。
さらに、句読点や表記形式まで見る指標として、トークン誤り率(TER)という発展的な指標もあります。同ドキュメントは「TERは語彙形式に加え、句読点、大文字小文字の区別、ITNなどの表示形式の側面も考慮に入れる」と説明しています。単語だけを数える指標では、読める文書に仕上がっているかまでは分からない、ということです。
一番危険なのは、滑らかに読める誤り
置換エラーは「ドメイン固有の用語」で起きやすいと、先のMicrosoftのドキュメントは指摘しています。そして、置換エラーの結果は目立ちません。
たとえば、会議で「今回はLX-820ラインで進めます」と話されたのに、文字起こしの結果が「LX-8200ライン」になっていたとします。文章としては完璧です。文法も句読点も整っていて、読んだだけでは違和感がありません。長い文章の中の数字ひと桁の違いは、WERのようなスコアにはほとんど反映されません。しかし、これは事実が変わっています。別の製品、別の判断です。
粗い誤りは安全です。読んだ人がすぐに気づき、原本を聞き直します。滑らかな誤りはそのまま議事録に載り、共有され、数週間後に問題になります。そしてこの種の誤りが起きやすいのは、専門用語や型番、英語の略語が日本語の文章に混じる、まさに業務音声の条件です。
公開されている精度スコアは、この種の誤りを個別には教えてくれません。順位表が示すのは誤りの「件数」であって、その誤りが資料を使えなくする種類かどうかではないからです。実務でこの差を埋める方法は二つしかありません。固有名詞をあらかじめツールに登録しておくか、仕上がった文書で名前・数字・製品名だけを重点的に見直すかです。
「精度」には二つの作業が混ざっている
「文字起こしの精度」と呼ばれるものには、実際には異なる二つの作業が含まれています。
一つ目は、音声を文字にする段階です。音声が入り、タイムスタンプ付きの生のテキストが出てきます。WERが測っているのはこの層です。
二つ目は、テキストを整える段階です。生のテキストを、人が読める文書に整えます。聞き間違えた単語を直し、話し言葉を読みやすい書き言葉に整理し、句読点や空白を補い、不要なつなぎ言葉を取り除きます。その過程で、事実は一つも変えないことが条件です。
この二つは、それぞれ別の壊れ方をします。生のテキストは良くてもタイムスタンプがずれて字幕に使えない場合があり、逆にタイムスタンプは正確でも固有名詞を間違える場合もあります。精度のパーセンテージ一つでは、どちらも捉えられません。
作るものによって、良い仕上がりの形も変わります。字幕は時間に合わせて短く区切られた行が必要で、慣例として句読点を入れません。議事録や逐語録は逆に、句読点と段落がないと読みにくくなります。「一番精度が高いモデルはどれか」という問いは、何を作りたいかを決めないと半分しか成立しません。
Subananaはモデルをどう選んでいるか
方針は単純です。音声の言語と用途に応じて、そのときいちばん評価の良い音声認識モデルに処理を振り分けます。 一つのベンダーに固定していません。字幕と議事録・逐語録では良い出力の形が違うため、振り分けは言語だけでなく用途も見て行います。
一つのモデルに固定しない理由は単純です。話していない内容を生成したり、話された内容を認識できなかったりする問題は、どのモデルでも起こり得ます。特定の一社に依存すると、その問題をそのまま引き継ぐことになります。
言語ごとの評価データは社内で継続的に取っていますが、その数値をブログでは公開していません。自社のサンプルと基準に紐づいた数字は、別の条件ではそのまま成り立たず、この記事が最初に指摘した「他人の条件で出た数字を自分の条件に当てはめる」問題を、もう一度作ってしまうからです。代わりに、仕組みを公開します。
- 品質に問題が出ると、自動的に別のモデルへ振り分けます。 出力に問題が見られた区間を、評価済みの別モデルへ回します。
- 編集画面では、聞き間違いや同音異義語の誤表記を修正候補として提案します。 適用するかどうかは、ユーザーが一件ずつ選べます。
- 1秒あたりの文字数(CPS)をもとに、読みにくい字幕を機械的に検出します。 AIが自信のなさを示す機能ではなく、読む速さを計算するルールベースの検査です。
- 固有名詞はあらかじめ登録できます。 会社名、人名、製品名、社内用語をワークスペース全体のリストやプロジェクトごとのリストに登録すると、その表記が優先されます。Excel・CSVでの一括登録にも対応しています。
- 逐語録・議事録モードでは、句読点と段落分けが自動で復元されます。 字幕モードには適用されません。字幕は慣例として句読点を入れないためです。
対応言語は日本語を含め95以上です。特定の一つのモデルに固定する設計ではなく、言語ごとに評価結果の良いモデルへ振り分けています。関連する選び方は、AI議事録ツールの比較記事でも整理しています。
話者分離とタイムスタンプ:誤り率が触れない二つ
単語をすべて正しく認識できても、結果が使えなくなる要素が二つあります。どちらもWERには含まれません。
話者分離。 議事録では「誰が話したか」が「何を話したか」と同じくらい重要です。Google CloudのSpeech-to-Text公式ドキュメント(日本語版)は、この機能を次のように説明しています。
Cloud Speech-to-Textは、音声クリップ内の複数の話者を認識できます。…この機能は「話者ダイアライゼーション」と呼ばれ、音声内で話者が変わったことを検出して、検出した各音声に番号でラベル付けします。 (異なる話者を検出する — Google Cloud、日本語ページ)
同ドキュメントはさらに、「文字変換で想定される話者の数に応じてmin_speaker_countとmax_speaker_countの値を設定する必要があります」と明記しています。話者の人数は、ユーザーが入力する条件だということです。ここが合っていないと、単語をすべて正しく認識できても、発言者の割り当てがずれます。Subananaの逐語録モードにも話者数の設定があり、手動入力と自動検出のどちらも選べます。参加人数が分かっている場合は、手動で入力するほうが安定します。
タイムスタンプ。 テキストの質が良くても、タイムスタンプが正確とは限りません。読むための逐語録であれば数秒のずれは問題になりませんが、動画に載せる字幕では、そのずれ一つで成果物全体が使えなくなります。公開されている順位表が報告するのは基本的にWERのような文字の誤り率で、タイムスタンプが映像に合っているかどうかはそこに含まれません。確認する方法は一つだけです。字幕を表示した状態で、実際に動画を再生してみることです。
購入前にチェックしたい5つのポイント
どのベンダーの「高精度」という説明にも、次の5つを当ててみてください。
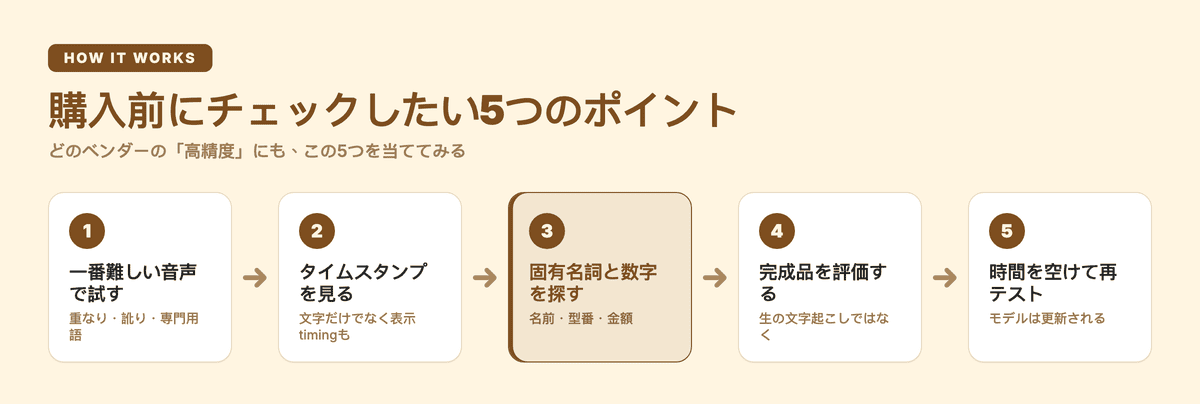
- 一番難しい音声で試す。 きれいなサンプルではなく、実際に使う予定の音声を使います。話者が重なる会議、専門用語の多いインタビュー、なまりのある話者、言語が切り替わる録音を優先してください。差が出るのは、簡単な音声ではなく難しい音声です。
- 文字だけでなくタイムスタンプを見る。 字幕を表示した状態で音声・動画を再生します。表示タイミングのずれは、文章の比較だけでは分かりません。
- 固有名詞と数字を重点的に探す。 人名、会社名、製品名、型番、金額、日付を音声と照らし合わせます。文章として自然に読めるほど、間違いは見逃しやすくなります。
- 生の文字起こしではなく、完成品を評価する。 実際に共有したり公開したりするのは、整形後の字幕や議事録です。修正にどれくらい手間がかかるかも記録してください。
- 時間を空けて再テストする。 AIモデルは更新されます。今月良かった結果が、次の更新後も同じとは限りません。重要な用途で使うなら、数か月おきに同じ音声で再テストする価値があります。
ベンダーに聞くべきなのは「精度は高いですか」だけではありません。「どんな音声で評価したのか」「事実が変わる誤りをどう見つけているのか」「モデルを更新した後、再評価しているのか」まで聞いてみてください。
よくある質問
文字起こしAIの精度はどう確認すればいい?
自分が実際に使う音声で試すのが一番確実です。話者の重なり、専門用語、言語の切り替えを含む音声を使い、文章だけでなくタイムスタンプ、固有名詞、数字、完成後の修正量を確認します。LibriSpeechのような代表的な公開データセットは読み上げ音声が中心なので、公開スコアだけでは実務の音声条件を代弁できません。
「高精度」をうたうツールは信用していい?
「高精度」という言葉だけでは判断できません。どの音声で評価したか、比較方法、事実の誤りをどう扱っているか、モデル更新後に再テストしているかを確認してください。Microsoftの公式ドキュメントが示すとおり、単語誤り率(WER)は誤りの種類を区別せず、句読点の抜けと固有名詞の誤りを同じ重みで数えます。
精度とタイムスタンプは違うもの?
違います。文章が正しくても、字幕の表示タイミングがずれることがあります。読むための逐語録なら影響は小さいですが、動画に載せる字幕では致命的です。字幕を表示した状態で音声を再生し、直接確認してください。
話者の人数は事前に指定したほうがいい?
指定できるなら指定したほうが安定します。Google CloudのSpeech-to-Text公式ドキュメントも、想定される話者数に応じて設定値を指定する必要があると案内しています。Subananaの逐語録モードにも話者数の設定があり、手動入力と自動検出の両方に対応しています。
なぜ複数のAIモデルを使い分けるの?
モデルごとに得意な言語や音声条件、文章整理の傾向が異なるためです。一つのモデルに固定するより、継続的な評価結果に応じて言語・用途ごとに振り分けるほうが、実際の音声に対応しやすくなります。
最後は、いちばん難しい音声で確かめる
文字起こしAIを選ぶとき、「高精度」という言葉だけで決める必要はありません。公開されているベンチマークが何を測り、何を見逃すかを知ったうえで、自分の最も難しい音声で、文章・タイムスタンプ・数字・固有名詞・完成後の修正量を確認してください。
Subananaでは、無料プランでもファイルの最初の15分までは仕上がりをその場で確認できます。まずはAI議事録・会議・文字起こしツールに、いちばん失敗してほしくない日本語音声をアップロードして、上記のポイントを試してみてください。