
인터뷰를 마치고 나면 손에는 한두 시간 분량의 음성 녹음 파일이 남습니다. 질적 연구 논문을 쓰든, UX 리서치 보고서를 작성하든, 기사를 준비하든 실제로 필요한 결과물은 같습니다. 누가 어떤 말을 했는지 명확히 나뉘어 있고, 논문이나 보고서에 곧바로 인용할 수 있는 완성된 인터뷰 대본입니다.
인터뷰 대본의 핵심 요구 사항은 세 가지입니다. 첫째, 텍스트가 정확해야 합니다. 둘째, 발화자가 누구인지(화자 구분) 확실히 구분되어야 합니다. 셋째, 그대로 복사해 인용하거나 코딩(Coding) 작업에 쓸 수 있어야 합니다. 대략적인 요약본이나 시간대별로 토막 난 자막으로는 이 세 조건을 채울 수 없고, 문맥이 살아 있는 완성형 문서라야 합니다.
인터뷰 녹음을 텍스트 대본으로 만드는 방법은 크게 세 가지입니다. 수작업 타이핑, 무료 자동 자막 도구, 그리고 AI 음성 텍스트 변환(STT)입니다. 세 방식 중 AI 전사가 대부분의 수작업 노동을 덜어내고, 사용자는 논문이나 기사에 직결되는 핵심 문장과 고유명사 위주로 마지막 교열만 진행하는 방식이 가장 효율적입니다.
인터뷰 대본과 일반 영상 자막의 차이점
많은 분이 인터뷰 녹음을 정리할 때 영상 자막(Subtitle) 도구를 그대로 쓰다가 낭패를 봅니다. 자막과 대본(Transcript)은 목적과 구조 자체가 다릅니다.
- 자막(Subtitles): 영상 화면 하단에 얹기 위한 텍스트입니다. 화면 호흡에 맞춰 1~2초 단위로 짧게 쪼개져 있으며, 통상적으로 문장 부호(마침표, 쉼표)를 생략합니다. 출력 형식도 SRT나 VTT 같은 자막 파일 위주입니다.
- 대본 및 녹취록(Transcript): 사람이 읽고 분석하기 위한 문서입니다. 완성된 문장 부호가 들어가고, 의미 단위로 문단이 나뉘며, "진행자", "참여자 A"처럼 화자 표시가 명확해야 합니다. 그래야 위아래 문맥을 파악하고 특정 발언을 그대로 인용할 수 있습니다.
인터뷰 녹음 파일을 자막 모드로 변환하면 문장 부호 없이 잘게 쪼개진 텍스트 수백 줄이 나열되어, 오히려 문맥을 파악하기가 더 힘들어집니다. 인터뷰 대본을 만들 때는 반드시 문장 부호와 단락 구분이 지원되는 전사 모드를 선택해야 합니다.
세 가지 대본 작성 방식 비교
인터뷰 녹음을 문단 형태의 대본으로 옮기는 세 가지 방법의 현실적인 장단점은 다음과 같습니다.
1. 수작업 타이핑 (인간 전사)
정확도의 상한선이 가장 높은 방식입니다. 전문 속기사나 연구자가 직접 들으며 치기 때문에 사투리나 전문 용어도 비교적 잘 잡아냅니다.
하지만 속도가 너무 느리고 비용이 큽니다. 통상적으로 1시간 분량의 녹음을 수작업으로 옮기려면 몇 시간이 걸리는 것으로 알려져 있으며(정확한 배수는 속기사의 숙련도와 음질에 따라 다름), 참여자가 3명 이상이거나 주변 소음이 섞여 있는 경우 작업 시간은 더 늘어납니다.
2. 무료 자동 자막 도구
빠르고 진입 장벽이 낮다는 장점이 있습니다. 그러나 인터뷰 대본 용도로는 치명적인 한계가 있습니다.
오인식률이 높아 문맥이 왜곡되기 쉽고, 대부분 화자 분리 기능을 지원하지 않아 모든 대화가 하나의 거대한 텍스트 덩어리로 합쳐집니다. 또한 문장 부호나 문단 구분이 없어, 긴 텍스트 벽을 일일이 읽으며 발화자를 직접 분리해야 하므로 후작업 시간이 길어집니다.
3. AI 음성 텍스트 변환 (전사 모드)
수작업보다 압도적으로 빠르고, 단순 무료 툴보다 오인식률이 훨씬 낮습니다. 특히 화자 식별(Diarization)과 자동 문장 부호, 단락 구분 기능이 결합되어 있어 곧바로 읽을 수 있는 인터뷰 대본 형태를 완성해 줍니다.
AI 전사가 훌륭한 초안을 만들어주더라도 마지막 검토 단계까지 완전히 대체할 수는 없습니다. 인터뷰이의 발언을 원문 그대로 인용(Direct Quotation)하기 전에는 고유명사, 숫자, 연구 전문 용어 등을 한 차례 확인하는 과정이 반드시 필요합니다.
Subanana로 인터뷰 녹음을 대본으로 변환하는 4단계
제가 Subanana를 운영하며 가장 공들인 기능 중 하나가 바로 질적 연구자, UX 리서처, 기자가 곧바로 현업에 쓸 수 있는 인터뷰 전사 워크플로를 만드는 것이었습니다. Subanana는 소스 언어별로 가장 성능이 뛰어난 음성 인식 엔진을 벤치마크하여 지속적으로 라우팅하며, "음...", "어..." 같은 불필요한 추임새 필터링, 정밀한 화자 분리, 문맥 기반 문장 부호 삽입을 지원합니다.
첫 단계에서 올바른 모드를 고르지 않으면 뒤 작업이 다 헛수고가 됩니다. 잘게 쪼개진 자막 줄이 아니라 완성된 인터뷰 대본을 얻으려면 반드시 **전사 모드(Transcription Mode)**를 선택해야 합니다.
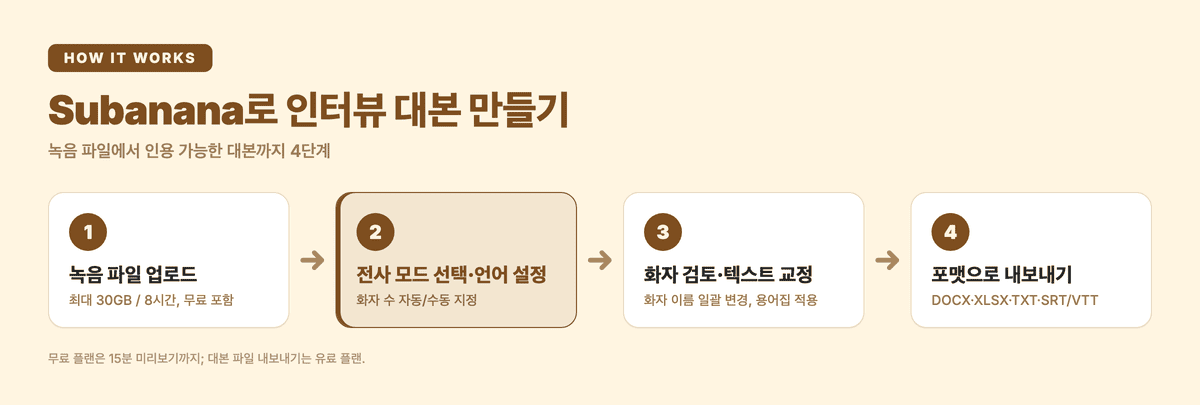
1단계: 녹음 파일 업로드
인터뷰 음성(MP3, M4A, WAV 등)이나 영상 파일을 직접 업로드합니다. 이미 유튜브나 페이스북 등에 공개 영상으로 올려두었다면 링크를 붙여넣어 불러올 수도 있습니다(비공개·회원 전용·연령 제한 등 접근이 제한된 영상은 지원되지 않으므로, 이런 경우 파일을 직접 업로드하세요). Subanana는 무료 플랜을 포함한 모든 플랜에서 단일 파일 기준 최대 30GB, 최장 8시간의 넉넉한 파일 규격을 지원하므로 2~3시간에 달하는 심층 인터뷰 파일도 한 번에 업로드할 수 있습니다.
2단계: 전사 모드 선택 및 언어 설정
작업 모드에서 전사 모드를 선택하고 소스 언어를 지정합니다(한국어를 포함해 95개 이상의 언어를 지원합니다). 화자 수 설정을 '자동 감지'로 두거나 인터뷰 참여 인원수(예: 2명)에 맞춰 수동 입력합니다. 문장 부호와 단락 나누기는 전사 모드에서 자동으로 적용되므로 별도로 켤 필요가 없습니다.
3단계: 화자 검토 및 텍스트 교정
변환이 끝나면 웹 에디터로 진입합니다. 시스템이 음성을 분석하여 Speaker 1, Speaker 2 등으로 발화자를 분리하고, 불필요한 추임새를 정돈한 뒤 문단 형태로 텍스트를 보여줍니다. 에디터에서는 다음과 같은 편집이 가능합니다.
- 화자 이름 일괄 변경:
Speaker 1을 클릭해 '진행자',Speaker 2를 '참여자 A'로 변경하면 대본 전체에 등장하는 해당 화자 태그가 한 번에 바뀝니다. - 오탈자 수정 및 사전(Glossary) 활용: 오인식된 단어는 텍스트를 클릭해 즉시 수정할 수 있습니다. 특정 업계 용어나 기관명, 인터뷰이 이름이 반복해서 등장한다면 작업 전 용어집에 등록해 두어 인식 정확도를 높일 수 있습니다.
- AI 대본 채팅(Chat with Transcript): 긴 인터뷰를 검토할 때 유용한 기능입니다. 에디터 내 AI에게 "참여자 A가 비용 문제에 대해 언급한 구간을 찾아줘", "이 인터뷰의 핵심 논점 3가지를 요약해 줘"와 같이 질문하여 인용할 핵심 구간을 빠르게 찾을 수 있습니다.
4단계: 목적에 맞는 포맷으로 내보내기
완성된 인터뷰 대본은 용도에 맞춰 다양한 형식으로 다운로드할 수 있습니다.
- DOCX(워드) / TXT: 인터뷰 내용을 읽기 편한 서식으로 바로 편집하거나 보고서 초안으로 옮길 때 적합합니다.
- XLSX(엑셀): 질적 연구 코딩이나 내용 분석을 진행할 때 유용합니다. 타임코드, 화자 이름, 발화 내용이 열 단위로 깔끔하게 분리되어 정렬됩니다.
- Markdown / SRT / VTT: 옵시디언이나 노션 같은 지식 관리 툴로 옮기거나, 인터뷰 영상을 편집해야 하는 경우 선택할 수 있습니다. (참고: HWP 포맷은 지원하지 않으므로 워드 DOCX 파일로 내려받아 한글 프로그램에서 불러오는 방식을 권장합니다.)
인터뷰 대본 작성 관련 자주 묻는 질문 (FAQ)
무료 플랜으로 인터뷰 대본 파일을 다운로드할 수 있나요?
무료 플랜은 서비스의 전사 품질과 화자 구분 성능을 검증해보실 수 있도록 제공됩니다. 업로드한 파일의 처음 15분 분량을 에디터에서 미리 확인하실 수 있습니다(월 최대 3회 업로드).
다만 무료 플랜에서는 대본 파일(TXT, DOCX, XLSX, MD) 및 자막 파일(SRT, VTT) 내보내기와 에디터 내 텍스트 전체 복사가 제한되며, 내보내기는 워터마크가 포함된 5분 / 720p 비디오 렌더링으로만 제공됩니다. 완성된 텍스트 대본 파일이 필요하시다면 유료 플랜(Lite, Pro, Max) 구독을 통해 워터마크를 제거하고 모든 형식의 파일 내보내기 기능을 이용하실 수 있습니다. 유료 요금제는 연간 결제 기준 월 $9(월간 결제 시 월 $18)부터 시작합니다.
여러 명이 동시에 이야기하는 그룹 인터뷰(FGI)도 화자가 나뉘나요?
네, 전사 모드의 화자 분리(Diarization) 기능은 3인 이상의 다자간 인터뷰에서도 작동합니다. 다만 두 사람이 완전히 동시에 겹쳐서 말하는 오버랩 구간은 AI가 분리하기 어려울 수 있으므로, 에디터에서 오버랩 구간만 가볍게 들어보며 문장을 다듬는 것을 권장합니다.
AI가 만든 대본을 논문이나 보도 기사에 그대로 인용해도 되나요?
초안으로서의 완성도는 매우 높지만, 중요한 연구 논문이나 기사에 직접 인용할 문장은 반드시 원본 오디오를 한 번 더 청취해 교열하는 과정이 안전합니다. 특히 인명, 통계 숫자, 전문 고유명사는 발음이 유사한 다른 단어로 표기될 가능성이 있으므로 최종 발행 전 확인을 권장합니다.
1~2시간이 넘는 장시간 인터뷰 녹음도 지원되나요?
네, 가능합니다. Subanana는 무료 플랜을 포함한 모든 플랜에 파일당 최대 30GB, 최장 8시간의 용량 한도를 동일하게 적용합니다. 2시간이 넘는 긴 녹음 파일도 문제없이 처리되며, 분량이 긴 인터뷰일수록 에디터 내의 'AI 대본 채팅' 기능을 활용해 원하는 주제의 타임코드를 먼저 검색하면 작업 시간을 크게 단축할 수 있습니다.
요금제별 지원 기능과 작업량에 대한 상세한 안내는 Subanana 요금제 안내 페이지에서 확인하실 수 있습니다.