대학은 실시간 자막에서 두 가지 분명한 요구를 갖고 있는데, 시중의 대다수 회의 전사 도구로는 이를 제대로 풀기 어렵습니다. 하나는 청각장애 및 난청 학생을 위한 접근성 지원으로, 많은 대학에서 법적 요건입니다. 다른 하나는 국제 학생 집단을 위한 언어 접근성입니다. 강연자는 한 언어로 강의하는데 객석의 학생들은 여러 언어로 읽어야 하죠.
대학이 이미 갖춘 강의 녹화 시스템, 즉 Panopto, Echo360, Zoom for Education, Microsoft Stream은 일부 문제를 해결합니다. 녹화본에 자동으로 자막을 생성해 수업 후 다시보기에 쓸 수 있게 해 주죠. 이 도구들의 초점은 녹화본에 붙는 자막입니다. 별개의 문제로 남는 것은 강의가 진행되는 바로 그 순간에, 학생 각자의 화면으로 필요한 언어의 자막을 내려보내는 일입니다. 뒷줄의 중국어 사용 학생은 자기 화면에서 중국어 간체 자막을 읽어야 합니다. 영어를 쓰는 접근성 요구 학생은 소스 언어 자막을 읽어야 하고, 청각장애 학생은 올바른 줄바꿈이 적용된 실시간 축어록을 봐야 합니다. 한 실시간 세션이 몇 개 언어를 담을 수 있는지, 그리고 그 선택권이 학생 각자의 화면까지 얼마나 내려오는지는 도구마다 다릅니다. 바로 그 차이가 아래 비교의 핵심입니다.
이 가이드는 대학이 실시간 자막 도구에 진짜로 필요로 하는 것, 강의 당일의 설정 방식, 그리고 각 현실적 선택지가 어떤 상황에 맞는지를 다룹니다. 여기에는 Subanana(제가 운영합니다), Wordly, 그리고 여러분의 기술 스택에 이미 들어 있는 강의 플랫폼 내장 자막이 들어갑니다.
대학이 진짜로 필요로 하는 것
제가 접해 본 대학들에서 세 가지 요구가 거듭 나타났습니다.
- 강의 진행 중에 참석자가 실시간으로 볼 수 있고, 학생 집단이 필요로 하는 언어를 포괄하는 자막. 녹화만을 위한 것이 아닙니다. 접근성이나 언어 때문에 자막이 필요한 학생은 24시간 뒤가 아니라 강의가 진행되는 바로 그 순간에 자막을 봐야 합니다. 한 도구가 한 세션 안에서 여러 목표 언어를 포괄하는지, 아니면 목표 언어마다 세션이 하나씩 필요한지는 실질적인 차별점이며, 이는 아래 비교에서 다룹니다.
- 유연한 오디오 소스. 어떤 강의는 핀 마이크와 음향 시스템을 쓰는 대면 형식이고, 어떤 강의는 혼합형(강연자는 현장에, 원격 학생은 Zoom)이며, 어떤 강의는 완전한 온라인입니다. 자막 도구는 강의실에서 실제로 쓰이는 소스의 오디오 입력을 받을 수 있어야 합니다.
- 학생 입장에서 "우리 앱을 설치할 필요가 없을 것". 200명의 대학생에게 매 강의 전에 어떤 앱을 설치하거나 SaaS 계정에 로그인하라고 요구하는 것은 현실적으로 불가능합니다. 링크나 QR 코드를 통한 브라우저 자막 표시가 대형 강의에서 유일하게 현실적인 배포 방식입니다.
대학 상황에 따라 추가되는 요구:
- 청각장애 및 난청 학생을 위한 접근성 준수(미국의 Section 508, EU의 EAA, 영국의 BS 8878).
- 기존 강의 녹화 시스템(Panopto, Echo360)과의 연동. 강의 후 자막 트랙이 녹화본에도 함께 들어가도록.
- 실제 학생 규모에 맞춰 조정하는 다국어 지원. 소규모 강의는 목표 언어 1개면 충분할 수 있고, 대형 국제 프로그램은 4개가 필요할 수 있습니다.
- 강의 고유 용어(강연자의 전문 용어, 고유명사, 기술 약어)를 위한 용어집 지원.
실무에서 작동하는 설정 형태
가장 자주 나타나는 설정 형태는 세 가지입니다. 올바른 선택은 강의 형식(대면/혼합/온라인), 음향·영상 장비, 그리고 IT 지원의 가용성에 달려 있습니다.
형태 1: 대면 강의, 핀 마이크, 실시간 브라우저 자막
강연자가 직접 강의실에서 핀 마이크나 핸드 마이크를 쓰고 청중이 현장에 있는 경우에 적합합니다.
- 오디오 입력. 마이크 신호를 자막 도구가 돌아가는 노트북에 연결합니다. 가장 간단한 방법은 USB 오디오 인터페이스로 음향·영상 시스템의 보조 출력(aux out)에서 신호를 받는 것입니다. 강의실 AV 장비에 깨끗한 aux out이 없다면, 대안으로 메인 마이크 옆에 핀 마이크를 하나 더 두고 별도의 USB 수신기에 연결하는 방법이 있습니다.
- 자막 도구는 노트북에서 실행됩니다. Subanana를 예로 들면, 노트북에서 브라우저로 실시간 세션 화면을 열고, 호스트(보통 AV 팀)가 강의 전에 소스 언어 하나와 번역 대상 언어를 최대 5개까지 설정한 뒤 세션을 시작합니다. 여러 언어가 한꺼번에 필요한 학생 집단도 그 노트북 한 대의 세션 하나로 감당됩니다. 대상 언어들이 세션 안에 함께 들어 있기 때문입니다.
- 청중 접근. 스크린에 표시되는 QR 코드(또는 강의 LMS에 미리 게시한 링크)가 학생의 휴대폰 브라우저에서 청중용 자막 화면을 엽니다. 그다음 학생은 자기가 읽을 언어를 하나 고릅니다. 원문이거나, 호스트가 그 세션에 설정해 둔 대상 언어 중 하나입니다.
- 강의 후 산출물. 모든 실시간 세션은 행사 오디오를 자동으로 녹음해 워크스페이스에 보관합니다. 자막 파일이 필요하면 AV 팀이 그 녹음을 Subanana의 파일 업로드 전사로 다시 처리합니다. 이 작업은 새 프로젝트로 처리되며 전사 분이 차감됩니다. 여기서 나온 SRT를 Panopto/Echo360 녹화본에 첨부하면 영구적인 접근성 커버리지가 완성됩니다.
형태 2: 혼합 강의, 원격 일부가 Zoom 또는 Teams 사용
강연자는 현장에 있지만 일부 학생이 Zoom/Teams/Meet으로 원격 참여하는 경우에 적합합니다.
- 오디오 입력. 플랫폼(Zoom/Teams)으로 보내는 동일한 마이크 신호를 자막 도구에도 함께 보냅니다. 가장 간단한 방법은 가상 오디오 케이블(Mac의 BlackHole, Windows의 VB-Cable)로 노트북의 시스템 오디오를 자막 도구에 연결하는 것입니다. 그러면 자막 도구는 Zoom 통화가 듣는 것과 같은 소리를 듣습니다.
- 자막 도구는 두 번째 기기에서 실행됩니다. 가장 좋은 방법은 전용 노트북 한 대로 자막을 돌려서 강연자의 Zoom 세션이 시스템 자원을 두고 경쟁하지 않게 하는 것입니다.
- 청중 접근. 현장 학생은 QR 코드를 스캔하고, 원격 학생은 Zoom 채팅이나 강의 LMS를 통해 청중용 자막 링크를 받습니다.
- 강의 후 산출물. 형태 1과 동일합니다. 세션의 오디오 녹음을 파일 업로드 전사로 다시 처리한 뒤, 그 프로젝트의 SRT를 강의 녹화본에 첨부합니다.
형태 3: 완전 온라인 강의, 순수 브라우저
강연자와 청중이 모두 원격인 경우에 적합합니다.
- 오디오 입력. 강연자의 마이크 신호를 강의 플랫폼(Zoom/Teams/Meet)과 자막 도구에 동시에 보냅니다. 강연자가 전부 한 기기에서 운영한다면, 가상 오디오 케이블로 Zoom 출력을 자막 도구로 되돌려 보낼 수 있습니다.
- 청중 접근. 자막 링크를 강의 LMS와 Zoom 채팅을 통해 배포합니다. 모두 이미 화면 앞에 있으므로 QR 코드는 필요 없습니다.
- 강의 후 산출물. 형태 1과 같은 경로입니다. 세션의 오디오 녹음을 파일 업로드 전사로 다시 처리하고, 그 SRT를 강의 녹화본에 첨부합니다.
도구 선택지 비교(문서 기반)
대학에는 각기 다른 트레이드오프를 가진 세 가지 현실적 선택지가 있습니다.
선택지 A: 강의 플랫폼 내장 자막(Panopto, Echo360, Zoom 실시간 전사)
강점: 새로운 공급사 관계를 맺을 필요가 없고, 이미 기술 스택에 들어 있으며, 강의 녹화본에 자동으로 첨부됩니다.
약점: 어떤 언어를 어느 범위까지 쓸 수 있는지가 플랫폼과 라이선스 등급에 따라 정해집니다. 학생 집단이 실제로 읽어야 하는 언어 목록에 맞춰 고르는 구조가 아니라는 뜻입니다. 자원이 적은 언어일수록 지원 목록에서 빠지거나 산출된 자막에 상당한 교정이 필요한 경향도 있습니다. 강의 하나에 필요한 언어 조합을 직접 짜야 하는 다국어 학생 집단이라면, 도입 전에 각 플랫폼의 현재 지원 언어와 등급 조건을 먼저 확인해 보세요.
적합한 상황: 강의도 청중도 한 언어로 돌아가서, 언어 번역이 아니라 접근성 자막만 필요한 경우.
선택지 B: Wordly
강점(Wordly 공식 문서 기준): 행사 시나리오를 위해 만들어진 엔터프라이즈급 실시간 번역과 자막입니다. 회사 설명으로는 수십 개 언어와 3,000개 이상의 언어 조합을 다루며, 번역·자막·축어록·요약 네 가지 제품을 하나의 가격에 묶어 제공합니다. 참석자는 자기 휴대폰이나 노트북에서 원하는 언어로 자막을 읽거나 음성으로 들을 수 있고, 주최 측이 허용하면 강의실 모니터에도 자막을 띄울 수 있습니다. Cvent, Zoom, Teams, Encore 같은 행사 플랫폼과 연동되고, 음향 믹서에 직접 연결하는 구성도 안내합니다. 보안 쪽으로는 SOC 2 Type II와 ISO 27001을 충족한다고 밝히고 있습니다.
약점: 가격이 구매하는 시간(hours) 단위로 정해지고, 실제 금액은 맞춤 제안서를 받아야 확인됩니다. 공개된 가격표를 보고 학과 예산에 맞는지 바로 판단할 수 없다는 뜻이죠. 교육 기관 할인과 물량 할인도 문의 절차를 거칩니다. 한 학기에 여러 학과에 걸쳐 50개 이상의 강의를 여는 대학이라면 필요한 시간 규모를 미리 산정해 조달 절차를 밟아야 합니다.
적합한 상황: 중앙 AV/접근성 팀을 보유하고, 엔터프라이즈 도구 조달을 위한 전용 예산이 있으며, 시간 단위 구매를 정당화할 만큼 행사량이 충분한 대형 연구중심 대학. 자세한 비교는 Subanana vs Wordly(2026)에 정리해 두었습니다.
선택지 C: Subanana
강점: 가격이 월간 구독으로 공개되어 있고 연간 시간 패키지를 먼저 살 필요가 없습니다. 처음 감을 잡아 볼 수 있도록 워크스페이스당 1회, 5분짜리 실시간 자막 체험이 붙어 있습니다. 호스트는 한 세션 안에 소스 언어 하나와 번역 대상 최대 5개를 설정할 수 있고, 실시간 분은 대상 언어 수와 무관하게 오디오 길이 기준으로 1회만 차감됩니다. 그래서 각 학과가 중앙 조달을 거치지 않고 셀프서비스로 쓸 수 있습니다. 학생 쪽은 앱 설치 없이 브라우저로 자막을 봅니다. 95+ 개 소스 언어를 언어별 최적 모델로 라우팅하고, 강사 이름과 학과명, 강의 고유 용어를 고정하는 용어집도 지원합니다.
약점: 한 실시간 세션이 담는 번역 대상은 최대 5개까지입니다. 같은 순간에 여섯 개 이상의 읽기 언어를 서비스해야 하는 강의는 이 형태를 벗어납니다. Wordly는 한 세션 안에서 더 많은 목표 언어를 기본으로 처리하고, 언어 조합의 폭도 3,000개 이상으로 훨씬 넓습니다. 학생 각자의 화면에 표시되는 자막은 한 번에 한 언어이고, 두 언어를 한 화면에 함께 띄우는 것은 강의실 스크린 투사 쪽 기능입니다. 실시간 자막은 모든 유료 등급에 포함된 기능이 아니라 Max 플랜 기능입니다. Zoom, Teams, WebEx와의 플랫폼별 깊은 연동도 이 형태에는 없습니다. 워크플로가 마이크나 가상 오디오 케이블을 통한 오디오 입력을 기반으로 하기 때문입니다. 번역 텍스트를 음성으로 내보내는 MP3 더빙은 제공하지 않고 텍스트 자막만 있으며, 현재 공개된 기능 집합에는 엔터프라이즈급 SSO나 데이터 저장 위치 설정도 없습니다. SRT 자막 트랙이나 축어록의 DOCX·XLSX·Markdown이 필요하다면, 강의가 끝난 뒤 세션의 오디오 녹음을 Subanana의 파일 업로드 전사로 다시 처리해야 합니다. 이 작업은 새 프로젝트로 처리되며 전사 분이 차감됩니다.
적합한 상황: 비교적 소규모 강의를 여는 대학이나 개별 학과, 약속을 하기 전에 실시간 자막이 적합한지 먼저 검증하고 싶은 경우, 또는 Wordly의 주된 사용 사례를 벗어난 다국어 커버리지가 필요한 경우. 연간 엔터프라이즈 계약 예산 승인을 받을 수 없는 학과는 Max 워크스페이스 구독 하나를 자체적으로 감당할 수 있습니다.
→ 제품: Subanana — 다국어 실시간 자막.
실무 워크플로: 고정 강의에 Subanana 설정하기
단일 언어로 고정 시리즈 강의를 열면서 학생들이 다른 언어(하나이든, 같은 세션이 함께 담는 두세 개이든)의 자막을 필요로 하는 학과의 경우, 실무 워크플로는 다음과 같습니다.
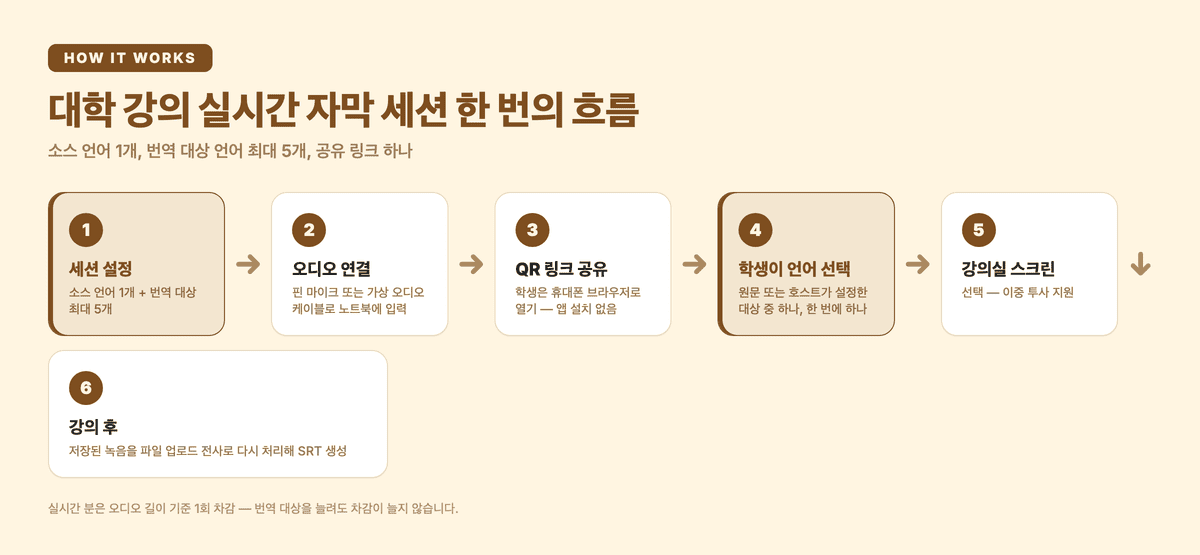
- 일회성 설정(첫 강의 약 30분 전). AV 팀이 오디오 라우팅을 자막 노트북에 연결합니다(AV aux out에 USB 인터페이스를 연결하거나 가상 오디오 케이블 사용). 학과 관리자가 Subanana 워크스페이스를 만들고, 소스 언어와 함께 학생 집단에 필요한 번역 대상 언어를 그 세션 하나에 최대 5개까지 미리 설정합니다.
- 강의 전(약 5분). AV 팀이 실시간 세션을 열어 음량을 확인하고 QR 코드를 생성해, 강의 슬라이드에 인쇄하거나 강의 시작 때 화면에 띄웁니다. 원격이나 늦게 들어오는 학생을 위해 청중용 자막 링크를 LMS에 미리 게시합니다.
- 강의 중. 자막은 백그라운드에서 실행됩니다. 강연자는 그것과 상호작용할 필요가 없습니다. 자막을 보려는 학생은 QR 코드를 스캔하거나 LMS 링크를 엽니다.
- 강의 후. 세션의 오디오 녹음은 이미 워크스페이스에 저장되어 있습니다. AV 팀은 그 녹음을 파일 업로드 전사로 다시 처리합니다. 전사 분으로 과금되는 새 전사입니다. 여기서 SRT를 내보낸 뒤 강의 녹화 시스템(Panopto/Echo360)에 업로드합니다. 그러면 자막 트랙이 녹화본에 첨부되어 영구적인 접근성 커버리지가 완성됩니다.
- 한 학기 내내. 설정해 둔 소스 언어와 번역 대상은 세션마다 그대로 이어지므로, 매 강의마다 다시 설정할 필요가 없습니다. 학기 중간에 강의 내용의 언어가 바뀐다면(영어 위주 강의에서 중국어로 강의하는 초청 강연자가 오는 경우), 호스트는 해당 강의 전에 실시간 세션 화면에서 소스 언어를 다시 설정하고 강의 후에 되돌릴 수 있습니다.
자주 묻는 질문
Subanana를 대학 강의 녹화 시스템과 연동할 수 있나요?
플랫폼별 깊은 연동 방식은 아닙니다. Subanana의 실시간 자막은 호스트의 마이크, 시스템 오디오, 또는 가상 오디오 케이블의 오디오 입력을 받습니다. 강의가 끝나면 세션의 오디오 녹음을 파일 업로드 전사로 다시 처리하고, 그 프로젝트의 SRT를 Panopto/Echo360에 올려 녹화 영상의 자막 트랙으로 씁니다. 이것이 대다수 대학에는 현실적인 연동 형태입니다.
Subanana가 접근성 준수(Section 508, EAA)를 처리할 수 있나요?
준수 여부는 소속 대학의 접근성 사무처가 청각장애 및 난청 학생을 위해 무엇을 요구하는지에 달려 있습니다. 보통 요구되는 것은 강의 중의 실시간 자막 트랙과 녹화본의 교정된 자막 트랙입니다. Subanana는 두 형태를 모두 커버합니다. 강의 중에는 실시간 자막을, 강의 후에는 세션의 오디오 녹음을 파일 업로드 전사로 다시 처리해 만든 자막 트랙을 제공합니다. 다만 그것이 여러분의 특정 준수 프레임워크에 부합하는지는 소속 대학의 정책에 달려 있습니다. Subanana는 현재 공식 Section 508 또는 EAA 적합성 문서를 발행하지 않으므로, 준수가 핵심인 상황에서 이를 신뢰하기 전에 먼저 접근성 사무처에 적합 여부를 확인하세요.
참석자의 언어 선택은 어떻게 작동하나요?
호스트는 세션이 시작되기 전에 소스 언어 하나(다국어 강연자라면 자동 감지)와 번역 대상 언어를 최대 5개까지 정해 둡니다. QR 코드나 공유 링크를 연 참석자는 각자 표시 언어를 하나 고릅니다. 원문이거나, 호스트가 설정해 둔 대상 중 하나입니다. 그래서 세션 하나가 중국어 독자, 한국어 독자, 영어 독자를 동시에 커버할 수 있습니다. 각자 자기 기기에서 한 언어씩 읽는 방식입니다. 참석자는 호스트가 설정한 언어 안에서만 고르므로, 학생 집단의 언어는 세션 설정 단계에서 챙겨야 합니다. 두 언어를 한 번에 보여 주는 것은 강의실 스크린 투사의 몫입니다(PiP 창, 또는 OBS·vMix·ProPresenter에 넣어 강의실 화면을 구동하는 브라우저 소스 URL). 학생이 개인적으로 설정하는 기능이 아닙니다.
좋은 실시간 자막을 얻으려면 오디오 품질이 어느 정도여야 하나요?
깨끗한 핀 마이크 신호(강연자 입에 가깝고 음향 스피커에서 먼)가 자막 정확도를 좌우하는 가장 큰 단일 요인입니다. 천장의 실내 마이크는 보통 실내 반향과 공조 소음을 함께 잡아내는 탓에 눈에 띄게 더 나쁜 자막을 만듭니다. 자막이 중요하다면 강의실의 실내 마이크 배열에 의존하기보다 핀 마이크나 핸드 마이크 구성을 우선하세요.
학생들이 복습용으로 자막을 다운로드할 수 있나요?
경로는 실시간 자막 화면이 아니라 행사 녹음을 지나갑니다. 실시간 축어록 자체는 어떤 형식으로도 내보낼 수 없습니다. 대신 각 세션이 오디오를 자동으로 녹음해 호스트의 워크스페이스에 보관하고, 호스트는 그 녹음을 Subanana의 파일 업로드 전사로 다시 처리합니다. 전사 분으로 과금되는 새 전사이며, 파일 하나에 소스 언어 하나를 지정합니다. 그렇게 만든 SRT(또는 축어록의 DOCX·XLSX·Markdown)를 내보냅니다. 대학은 보통 이 SRT를 Panopto/Echo360의 강의 녹화본에 첨부합니다. 학생은 녹화본의 자막 트랙 형태로 이용하며 검색해 복습할 수 있습니다. 강연자가 원한다면 파일을 학생들에게 직접 나눠 줘도 됩니다.
Subanana 가격은 학과 전체나 대학 규모로 어떻게 조정되나요?
Subanana의 공개 가격은 워크스페이스 기반입니다. 학과 단위 워크스페이스 하나가 거기서 세션을 여는 강연자들을 포괄하며, 실시간 자막은 Max 플랜에 올라가 있으므로 세션을 운영하는 학과가 구독하는 등급이 바로 그 플랜입니다. 전교 도입의 경우, 워크스페이스 구조에 물량 논의를 더하는 것이 흔한 경로입니다. 세션별 시간제 요금제(Wordly의 방식)는 Subanana가 판매하는 형태가 아닙니다. 조달에서 그런 가격 형태가 특별히 필요하다면, Wordly가 바로 그것을 위해 만들어졌습니다.