
Je hebt je interviews afgenomen, je hebt de opnames, en dan komt de vraag waar veel scripties vastlopen: hoe maak je van veertig pagina's gesprek een onderbouwde conclusie? Het antwoord heet coderen, en de eerste fase daarvan heet open coderen: je hangt korte labels aan fragmenten uit je transcript, zonder nog te ordenen, zodat je patronen ziet die over losse interviews heen lopen. Daarna volgen axiaal en selectief coderen — de twee fases die van die losse labels een verhaal maken dat je kunt verdedigen.
Eén verduidelijking vooraf, want de term is dubbelzinnig in het Nederlands: coderen heeft hier niets met programmeren te maken. Dit gaat over kwalitatieve analyse. Sommige onderzoekers zeggen ook "taggen" voor dezelfde handeling.
Openheid: ik run Subanana, een AI-transcriptietool. Subanana maakt het transcript — het codeert je interviews niet. Wat hieronder staat over de codeerfases is methodologie, geen productverhaal.
Wat wordt bedoeld met coderen?
Coderen is het toekennen van korte labels — codes — aan fragmenten in je transcript. Een code is een kernwoord, een korte zin of een symbool dat samenvat waar dat fragment over gaat. Door dezelfde code aan fragmenten uit verschillende interviews te hangen, kun je later terugzoeken wat al je respondenten over één thema zeiden.
Het doel is orde. Je hebt een grote stapel tekst en je moet er verantwoorde conclusies uit trekken; codes zijn het gereedschap dat dat mogelijk maakt.
Let op één belangrijk verschil. In kwalitatief onderzoek zijn codes woorden. In kwantitatief onderzoek betekent coderen iets anders: dan ken je nummers toe aan antwoordcategorieën, zodat je ze statistisch kunt verwerken in bijvoorbeeld SPSS of R. Zelfde woord, andere handeling. De drie fases hieronder gaan over de kwalitatieve variant.
Wat zijn de 3 fases van coderen?
De drie fases zijn open coderen, axiaal coderen en selectief coderen. Dit is de standaardindeling in het Nederlandse taalgebied: zowel Scribbr als Scriptium beschrijven het codeerproces in precies deze drie fases, met precies deze termen.
Gebruik die termen ook letterlijk in je scriptie. Als je begeleider vraagt "heb je axiaal gecodeerd?", verwacht die dit vocabulaire terug.
De procedure komt uit de grounded theory-traditie en wordt geassocieerd met Strauss en Corbin; hun Basics of Qualitative Research is het standaardwerk (SAGE). Grounded theory zelf gaat terug op Glaser en Strauss (1967).
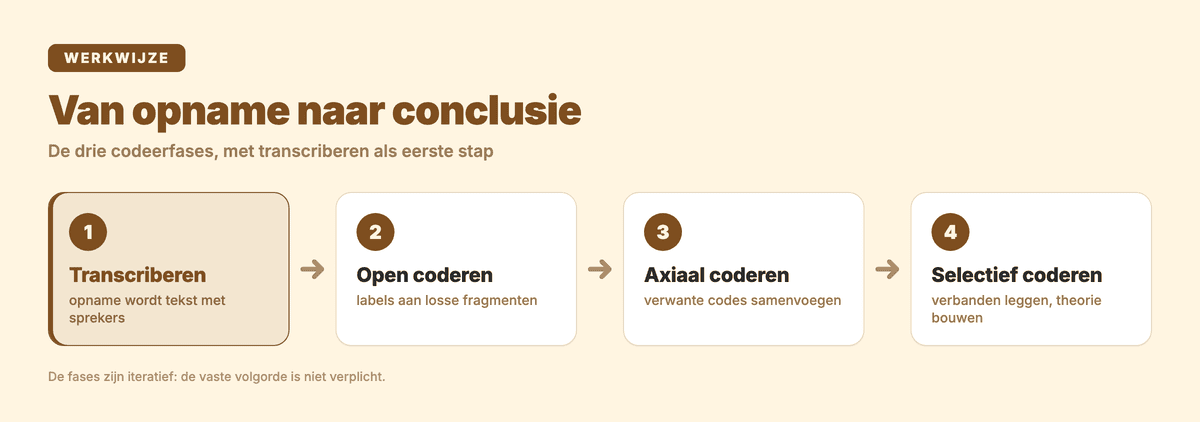
Eén nuance die beide Nederlandse bronnen benadrukken en die je in je methodehoofdstuk mag noemen: de volgorde ligt niet vast. Scribbr noemt het uitdrukkelijk geen vaststaand of lineair proces, en Scriptium schrijft dat het niet altijd nodig is de drie fases in die volgorde te doorlopen. In de praktijk ga je heen en weer — je vindt tijdens het axiaal coderen een nieuw thema en codeert een stuk opnieuw open. Dat is geen fout, dat is hoe het werkt.
Stap 0: eerst transcriberen
Voordat je kunt coderen, moet je interview op papier staan. Scribbr zet transcriberen niet voor niets als stap 1 van het hele proces: je codeert tekstfragmenten, dus je hebt tekst nodig.
Voor die stap geldt één praktische eis die vaak wordt onderschat: je transcript moet weergeven wie wat zei. Zonder sprekerlabels kun je een citaat later niet toeschrijven, en een niet-toeschrijfbaar citaat is onbruikbaar in je resultatenhoofdstuk. Hoe je dat aanpakt staat in ons artikel over een interview transcriberen.
Fase 1: open coderen
Je leest het transcript door en hangt labels aan fragmenten. Per fragment stel je één vraag: waar gaat dit in de kern over?
In deze fase ben je bewust ruimhartig. Je bedenkt codes terwijl je leest, je hebt er al snel enkele tientallen, en dat hoort zo. Je bent aan het inventariseren, nog niet aan het ordenen.
Een voorbeeld. Stel dat een respondent in een interview over thuiswerken zegt: "Ik doe 's avonds toch nog even mijn mail open, ook al hoeft het niet van mijn leidinggevende." Aan dat ene fragment kun je bijvoorbeeld de codes grens werk-privé, zelfopgelegde bereikbaarheid en avondwerk hangen. Drie labels op één fragment mag: je legt hier nog niets vast, je brengt alleen in kaart wat er in de tekst gebeurt.
Een praktische tip: codeer je eerste twee interviews, stop, en kijk naar je codelijst. Bijna altijd zie je dan dat je twee keer hetzelfde hebt gelabeld met verschillende woorden. Dat opruimen is het bruggetje naar de volgende fase.
Fase 2: axiaal coderen
Nu vergelijk je de codes onderling en breng je verwante codes samen onder een overkoepelende code. Van dertig losse labels ga je naar bijvoorbeeld zes categorieën.
Twee dingen die hier vaak misgaan:
- Een code mag onder meerdere overkoepelende codes vallen. Dat is toegestaan en vaak juist informatief — het laat zien dat een thema twee kanten raakt.
- Een categorie met één code eronder is meestal geen categorie. Kijk of dat fragment ergens anders bij hoort, of dat je hem echt apart wilt houden.
Aan het eind van deze fase heb je een structuur in plaats van een lijst.
Fase 3: selectief coderen
Hier stop je feitelijk met coderen. Je neemt de hoofdcategorieën uit de vorige fase en legt de verbanden: welke categorie verklaart welke, wat hangt met wat samen, en welk verhaal vertelt dat samen over je onderzoeksvraag?
Scriptium formuleert het zuiver — in deze stap ben je niet letterlijk meer aan het coderen. Je bouwt je theorie. Dit is de fase die je resultaten- en conclusiehoofdstuk voedt, en het is de fase die begeleiders het vaakst te dun vinden, omdat studenten na het axiaal coderen denken dat ze klaar zijn.
Welk interviewtype heb je eigenlijk afgenomen?
Dit bepaalt hoeveel codeerwerk je hebt, en het wordt zelden expliciet gemaakt.
De belangrijkste interviewvormen zijn het gestructureerde, het semigestructureerde en het ongestructureerde interview:
| Type | Wat het is | Wat het betekent voor coderen |
|---|---|---|
| Gestructureerd | Vaste vragen, vaste volgorde, iedere respondent onder gelijke condities | Vaak al vooraf gecodeerd vanuit de theorie; open en axiaal coderen kun je meestal overslaan |
| Semigestructureerd | Een leidraad met bredere vragen waar je van mag afwijken om door te vragen | Dit is waar de drie fases voor geschreven zijn — volledig codeerwerk |
| Ongestructureerd | Een topiclijst in plaats van vragen, vrije volgorde, informeel | Volledig codeerwerk, en meestal het meeste materiaal |
De meeste scriptie-interviews zijn semigestructureerd. Als dat voor jou geldt: je doorloopt alle drie de fases.
Voor de volledigheid — dit zijn de drie belangrijkste vormen, niet de enige. Scribbr noemt daarnaast onder meer het focusgroepsinterview, het groepsinterview en het expertinterview.
Software: heb je het nodig, en wat leest je transcript in?
Eerst het eerlijke antwoord: nee, software is niet verplicht. Met drie interviews kom je met een tabel in Word of Excel prima weg — een kolom met citaten, een kolom met codes.
Zodra je meer dan een handvol interviews hebt, wordt terugzoeken het probleem, en dan verdient een echt analyseprogramma zich terug. De drie die Nederlandse instellingen doorgaans licentiëren:
- ATLAS.ti — voor kwalitatieve analyse: ongestructureerde data zoals tekst, beeld, audio, video en kaarten coderen, doorzoeken en visualiseren in bijvoorbeeld co-occurrence-matrices en netwerkdiagrammen.
- MAXQDA — kwalitatieve analyse met ingebouwde transcriptie- en AI-functies in één pakket, volgens de eigen documentatie van MAXQDA.
- NVivo (Lumivero) — gericht op het omzetten van interviews, open enquêtevragen, documenten en multimedia naar gecodeerd, doorzoekbaar materiaal.
Twee kanttekeningen. ATLAS.ti en MAXQDA noemen zichzelf allebei "#1" op hun eigen homepage; dat is marketing van de leverancier, geen vastgesteld feit. En belangrijker: kijk eerst bij je eigen instelling. Nederlandse hogescholen en universiteiten hebben vaak een campuslicentie én een eigen handleiding — de bibliotheken van Saxion en Hanze publiceren bijvoorbeeld allebei ATLAS.ti-begeleiding voor studenten. Dat scheelt je een aanschaf.
In welk formaat moet je transcript staan?
Dit is de praktische vraag die je pas tegenkomt als je al bezig bent. Volgens de documentatie van de drie pakketten:
| Pakket | Gedocumenteerde importformaten voor een transcript |
|---|---|
| ATLAS.ti | .doc, .docx, .rtf, .odt, .htm, .html, .txt |
| MAXQDA | doc/x, odt, rtf, txt, md — en daarnaast srt als eigen importtype |
| NVivo | .doc, .docx, .rtf, .txt, plus PDF |
Kort samengevat: DOCX en TXT werken overal. Zorg dat je transcript in een van die twee staat, dan hoef je niets om te zetten.
Eén waarschuwing: het importeren van transcriptregels die met tijdcodes aan je audio gekoppeld blijven, stelt bij NVivo extra opmaakeisen. Reken daar niet op zonder het te testen. Een transcript als gewoon document inlezen is wat de documentatie zonder voorbehoud beschrijft.
Waar Subanana in past — en waar niet
Laat ik hier expliciet zijn, want het is verleidelijk om meer te beloven: Subanana codeert je interviews niet. Er is geen codeerfunctie, geen automatische thema-extractie voor kwalitatieve analyse en geen koppeling met ATLAS.ti, MAXQDA of NVivo. Het analytische werk in dit artikel — de drie fases — doe je zelf, en dat hoort ook zo, want het is precies het deel waarop je beoordeeld wordt.
Wat Subanana wel doet, is stap 1: van je opname een bruikbaar transcript maken.
- Sprekerherkenning, zodat citaten toewijsbaar zijn.
- Bestanden tot 30 GB en 8 uur, op alle plannen inclusief het gratis plan — een lang groepsinterview past er in één keer in.
- Taalspecifieke routering: Subanana toetst doorlopend verschillende spraakmodellen en kiest per brontaal het best presterende model, over meer dan 95 ondersteunde talen.
- Export als DOCX of TXT — precies de formaten die je codeersoftware inleest.
De eerlijke beperking erbij: exporteren zit op de betaalde plannen. Op het gratis plan zie je de eerste 15 minuten van elk bestand als voorbeeld en kun je drie bestanden per maand uploaden, maar je kunt het transcript daar niet downloaden en ook niet uit de editor kopiëren. Voor een scriptie waarin je het transcript als bijlage moet opnemen, is het gratis plan dus niet genoeg — die verwachting stel ik liever vooraf bij dan achteraf.
Werk je aan onderzoeksinterviews, dan staat op onze pagina over woordelijke interviewtranscriptie hoe die workflow er precies uitziet.
Veelgestelde vragen
Wat is open coderen?
Open coderen is de eerste van de drie codeerfases: je leest je transcript door en hangt labels aan fragmenten. Per fragment stel je één vraag: waar gaat dit in de kern over? In deze fase ben je bewust ruimhartig — je verzamelt codes, je hebt er al snel enkele tientallen, en je ordent nog niet. Dat ordenen komt in de volgende fase, axiaal coderen.
Wat is het verschil tussen open en axiaal coderen?
Bij open coderen geef je losse fragmenten een label, zonder al na te denken over structuur. Bij axiaal coderen vergelijk je die codes onderling en breng je verwante codes samen onder een overkoepelende code, zodat je van bijvoorbeeld dertig losse labels naar zes categorieën gaat. Kort gezegd: open coderen verzamelt, axiaal coderen ordent.
Wat zijn de 3 fases van coderen?
Open coderen, axiaal coderen en selectief coderen. Bij open coderen hang je labels aan losse fragmenten in je transcript. Bij axiaal coderen breng je verwante codes samen onder overkoepelende codes. Bij selectief coderen leg je de verbanden tussen die hoofdcategorieën en bouw je je theorie. De fases zijn iteratief: zowel Scribbr als Scriptium wijzen erop dat de vaste volgorde niet verplicht is en je in de praktijk heen en weer beweegt.
Welke 3 typen interviews zijn er?
De drie belangrijkste vormen zijn het gestructureerde, het semigestructureerde en het ongestructureerde interview. Gestructureerd betekent vaste vragen in vaste volgorde, meestal al vooraf gecodeerd. Semigestructureerd werkt met een leidraad waarvan je mag afwijken en is de vorm waar de drie codeerfases voor bedoeld zijn. Ongestructureerd werkt met een topiclijst in plaats van vragen. Er bestaan daarnaast nog andere vormen, zoals het focusgroeps- en het expertinterview.
Hoe transcribeer ik een interview voor kwalitatieve codering?
Voor open coderen werk je met tekstfragmenten, dus je hebt eerst een volledig transcript nodig — en dat transcript moet weergeven wie wat zei, anders kun je een citaat later niet toeschrijven (meer daarover in ons artikel over een transcript maken van audio). Subanana's Transcript-modus doet dat basiswerk: sprekerherkenning scheidt de sprekers, plus automatische interpunctie en alineavorming, zodat je een leesbaar document krijgt in plaats van een aaneengeschreven tekstblok. Op een betaald plan exporteer je dat transcript als DOCX of TXT — precies de formaten die ATLAS.ti, MAXQDA en NVivo inlezen — en dan kun je beginnen met open coderen.