
팀 회의나 심층 인터뷰 녹음 파일을 텍스트로 변환해 본 사람이라면 누구나 비슷한 문제를 겪어보았을 것입니다. 변환 자체는 잘 끝났는데, 결과물을 열어보면 줄바꿈도 없이 수만 자의 글자가 빼곡히 뭉쳐 있는 경우입니다.
누가 어떤 의견을 냈는지, 어떤 발언에 대해 누가 동의했는지 알 수 없다면 그 텍스트는 온전한 회의록이 될 수 없습니다. 결국 음성 파일을 다시 재생하며 일일이 화자의 이름을 타이핑해야 합니다. 녹음 데이터를 실제로 활용 가능한 회의록이나 인터뷰 녹취록으로 만들려면 반드시 '화자 분리(Speaker Diarization)' 과정이 선행되어야 합니다.
화자 분리와 음성 인식(STT)은 완전히 다른 기술입니다
많은 사용자가 음성 인식 인공지능이 말의 내용과 말한 사람을 한 번에 파악한다고 생각합니다. 하지만 실제로는 기술적으로 두 단계의 서로 다른 처리가 이루어집니다.
- 음성 인식(STT, Speech-to-Text): "무엇을 말했는가"를 처리합니다. 사람의 음성 파형을 단어와 문장 텍스트로 변환하는 기술입니다.
- 화자 분리(Speaker Diarization): "누가 언제 말했는가"를 처리합니다. 음성의 고유한 주파수와 음색 특징을 분석하여 화자가 바뀌는 시점을 찾아내고, 오디오 구간마다 '화자 1', '화자 2'와 같은 고유 식별 번호를 부여합니다.
Google Cloud의 음성 인식 기술 문서에서도 화자 분리는 기본 텍스트 변환 요청과 독립된 별도의 파라미터이자 처리 레이어로 설명되어 있습니다. 즉, 음성 인식 모델이 단어를 받아적는 동안, 화자 분리 모델은 오디오 전반에 걸쳐 음향 지문을 군집화(Clustering)하는 작업을 수행합니다.
이 두 가지 레이어가 함께 정상적으로 작동해야만 비로소 "화자 A: 프로젝트 일정 공유하겠습니다", "화자 B: 네, 확인했습니다"와 같이 사람별로 정리된 대본이 완성됩니다. 다자간 회의, 포커스 그룹 인터뷰(FGI), 다수의 패널이 참여하는 팟캐스트처럼 둘 이상의 목소리가 섞이는 환경에서는 화자 분리의 지원 여부가 작업 시간을 크게 좌우합니다.
화자 분리에서 오류가 발생하는 4가지 상황
화자 분리 알고리즘은 오디오 신호의 물리적 특성을 기반으로 작동합니다. 따라서 녹음 환경의 변수에 따라 한 사람의 말이 둘로 쪼개지거나, 두 사람의 발언이 한 사람으로 묶이는 오분류가 발생할 수 있습니다. 대표적인 원인은 다음과 같습니다.
1. 발화 중첩 (Overlapping Speech)
참석자들의 말이 겹치는 순간입니다. 상대방의 말에 맞장구를 치거나 중간에 끼어드는 상황이 잦아지면 오디오 파형이 섞이게 됩니다. 알고리즘은 목소리의 경계를 명확하게 구분하지 못하고 화자 라벨을 잘못 지정하게 됩니다.
2. 음색과 성별이 매우 유사한 경우
동일 성별에 연령대가 비슷하고 목소리의 톤이나 발성 습관까지 유사한 화자들이 대화할 때 발생합니다. 알고리즘이 추출하는 음향 특징 벡터(Embedding) 간의 거리가 좁아져 동일 인물로 묶어버리는 실수가 생깁니다.
3. 마이크와의 거리 차이 및 회의실 울림
넓은 회의실 테이블 중앙에 스마트폰 하나만 두고 회의를 녹음하는 형태가 대표적입니다. 마이크 가까이에 앉은 사람은 또렷하게 기록되지만, 멀리 떨어진 사람의 음성은 공간 울림(Reverberation)과 주변 잡음이 섞여 음성 특유의 신호가 희미해집니다. 이로 인해 같은 사람이 말하더라도 위치나 고개 방향에 따라 다른 화자로 분류되기도 합니다.
4. 압축 손실이 심한 오디오 파일
일반 전화 통화 녹음이나 압축률이 높은 화상 회의 플랫폼에서 추출한 오디오는 데이터 용량을 줄이기 위해 특정 주파수 대역이 잘려 나갑니다. 목소리의 고유한 질감이 사라진 상태이기 때문에 인공지능이 화자를 구분해낼 단서 자체가 부족해집니다.
반대로 생각하면 녹음 환경을 조금만 신경 써도 화자 분리의 결과는 눈에 띄게 좋아집니다. 참석자 각자에게 핀마이크나 지향성 마이크를 사용하게 하거나, 회의 진행자가 발언 순서를 정돈해 겹쳐 말하는 현상만 줄여도 분리 품질이 달라집니다. 특히 도구 사용 시 회의 참여 인원수를 사전에 지정할 수 있다면, 완전 자동 감지 모드에 맡기는 것보다 훨씬 안정적인 결과를 얻을 수 있습니다.
화자 분리를 구현하는 3가지 경로
현재 화자 분리가 적용된 텍스트 변환을 얻는 방법은 크게 세 가지로 나뉩니다. 목적과 작업 환경에 따라 적합한 방식을 선택해야 합니다.
1. 클라우드 AI 도구 (가장 간편한 방식)
웹 브라우저를 통해 오디오나 비디오 파일을 업로드하면, 서버에서 텍스트 변환과 화자 분리를 한 번에 자동 처리하는 방식입니다. 별도의 프로그램 설치나 고사양 하드웨어 없이 링크나 파일 업로드만으로 몇 분 안에 결과를 확인할 수 있습니다. 일반적인 비즈니스 회의록 작성이나 인터뷰 정리에 가장 널리 쓰입니다.
2. 로컬 Whisper + pyannote 조합 (엔지니어링 중심, 무료 오픈소스)
보안 규정상 음성 데이터가 외부 서버나 클라우드로 나갈 수 없는 환경이라면 오픈소스 모델을 직접 로컬 컴퓨터에 구축해야 합니다.
OpenAI의 Whisper는 뛰어난 음성 인식 성능을 자랑하지만, 자체적으로는 화자 분리 기능을 지원하지 않습니다. 따라서 오픈소스 생태계에서는 오디오 분할 및 화자 식별 라이브러리인 pyannote를 결합해 파이프라인을 구성하는 방식을 주로 활용합니다. 음성 활동 감지(VAD)와 중첩 발화 감지, 화자 클러스터링을 순차적으로 수행한 뒤 Whisper의 타임스탬프와 결합하는 구조입니다.
데이터가 내 컴퓨터 안에서만 머문다는 강력한 장점이 있지만, 고사양의 외장 GPU 환경이 필수적이며 파이썬 환경 설정과 모델 가중치 다운로드 등 기술적 진입 장벽이 높습니다.
3. 전용 회의 녹음 하드웨어
마이크 어레이가 장착된 전용 회의 녹음기를 활용하는 방식입니다. 기기 자체에서 소리가 나는 물리적 방향을 감지하여 발언자를 1차적으로 나눈 뒤 전용 소프트웨어로 텍스트화합니다. 오프라인 정기 회의가 잦은 기업에는 훌륭한 선택지이지만, 전용 장비 도입 비용이 발생한다는 점을 고려해야 합니다.
Subanana로 화자별 회의록 작성하기
클라우드 기반 AI 도구인 Subanana를 이용하면 복잡한 설정 없이 브라우저에서 바로 화자 분리가 적용된 대본을 생성할 수 있습니다.
회의가 아니라 인터뷰 녹음에 화자 분리를 적용하는 경우라면 인터뷰 전사 페이지가 그 쪽 흐름을 다룹니다.
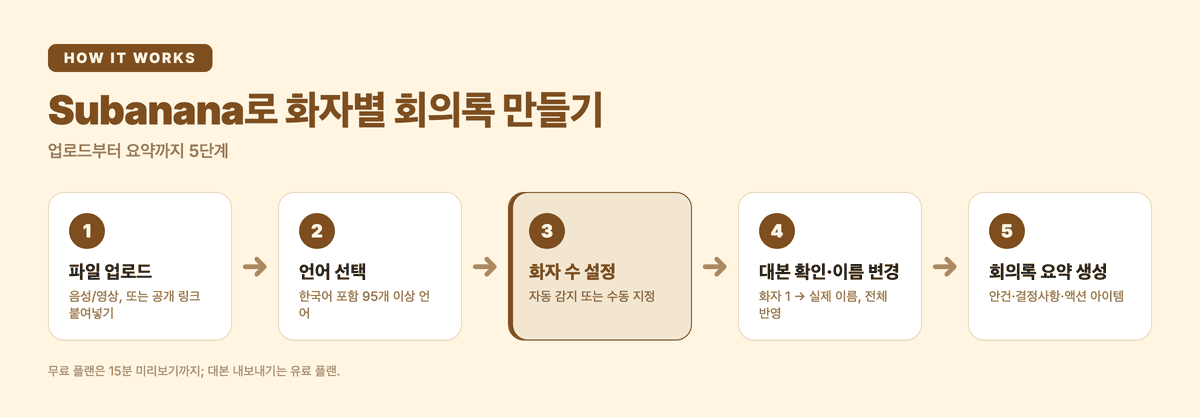
- 녹음 또는 영상 파일 업로드: 로컬 기기의 음성/영상 파일(파일당 최대 30GB 또는 최대 8시간)을 직접 올리거나, 공개된 YouTube, Instagram, Facebook 링크를 붙여넣습니다.
- 언어 선택: 한국어를 포함해 전 세계 95개 이상의 지원 언어 중 원본 음성의 언어를 선택합니다.
- 화자 수 설정: 시스템이 자동으로 참여자 수를 감지하도록 둘 수도 있고, 회의 참여자 수를 미리 알고 있다면 숫자를 직접 지정하여 정확도를 높일 수 있습니다.
- 대본 확인 및 화자 이름 변경: 변환이 완료되면 발언자별로 문단이 나뉘고 문장 부호가 정돈된 텍스트가 나타납니다. '화자 1', '화자 2'로 표시된 라벨을 실제 참석자의 이름(예: "김 팀장", "박 책임")으로 한 번만 수정하면 전체 대본에 즉시 반영됩니다.
- 회의록 요약 생성: 전체 대본을 바탕으로 핵심 안건, 결정 사항, 액션 아이템을 자동으로 추출합니다. 30개 이상의 AI 템플릿 중 회의 성격에 맞는 양식을 선택할 수 있습니다.
변환 직후 1~2분 정도 시간을 들여 화자가 바뀌는 지점의 이름을 훑어보며 수정하는 작업은 최종 회의록의 완성도를 높이는 데 가장 효과적인 단계입니다.
무료 플랜에서는 업로드한 모든 파일의 첫 15분 미리보기를 제공하며(월 3회 업로드 가능, 파일당 30GB 및 8시간 한도는 유료와 동일), 자막이 들어간 720p 영상(최대 5분, 워터마크 포함) 내보내기가 가능합니다.
회의록이나 자막 파일(SRT, VTT, TXT, DOCX, XLSX, Markdown) 내보내기 기능은 유료 플랜에서 제공됩니다. 플랜별 가격과 사용량은 Subanana 요금 안내 페이지에서 확인할 수 있습니다.
Subanana가 적합하지 않은 경우
사내 보안 내규상 음성 파일이 외부 클라우드로 전송되는 것 자체가 엄격히 금지된 환경이라면, 로컬 환경에 Whisper와 pyannote를 직접 구축하거나, Subanana의 온프레미스(엔터프라이즈 전용, 별도 문의) 도입을 검토하는 경로가 있습니다. 또한 회의실의 울림이 심하거나 마이크가 없어 원본 녹음 품질 자체가 극도로 떨어지는 상태라면, 도구를 바꾸기 전에 개별 마이크 구비 등 수음 환경부터 개선하는 것이 우선입니다.
자주 묻는 질문 (FAQ)
Q. 사투리나 억양이 강한 발화자도 화자가 분리되나요?
네, 분리됩니다. 화자 분리 알고리즘은 언어의 어휘나 문법 구조를 분석하는 것이 아니라, 목소리의 음향적 주파수 대역, 성도(Vocal Tract)의 울림, 피치 등 물리적인 소리의 지문을 분석합니다. 따라서 억양이나 사투리가 강하더라도 목소리 자체의 음향 특성이 뚜렷하다면 화자 분리는 안정적으로 작동합니다. 다만 사투리로 인해 표준어 기반 텍스트 변환(STT) 과정에서 단어 오인식이 생길 수는 있으므로, 변환 후 텍스트 교정이 필요할 수 있습니다.
Q. 화자 수를 사전에 수동으로 입력하는 것이 왜 더 유리한가요?
인공지능 모델이 스스로 화자 수를 추정할 때는 비슷한 음향 지문을 몇 개의 클러스터로 묶어야 할지 임계값(Threshold)을 스스로 계산해야 합니다. 이 과정에서 한 사람의 발언 톤이 바뀌었을 때 새로운 화자로 착각하거나, 반대로 다른 사람의 짧은 추임새를 인접한 화자에게 병합해 버리는 일이 발생할 수 있습니다. 정확한 인원수를 미리 전달하면 모델이 찾아내야 할 클러스터의 목표 개수가 고정되므로 오분류 확률이 크게 줄어듭니다.
Q. 변환된 대본에서 화자 이름을 한 번에 바꿀 수 있나요?
네, 가능합니다. 시스템이 분류한 '화자 1'을 클릭하여 실제 이름으로 변경하면, 해당 화자로 지정된 대본 내 모든 발화 구간의 이름이 일괄 변경됩니다.
플랜별 기능 차이와 상세 요금 체계는 Subanana 요금 안내 페이지에서 확인할 수 있습니다.