
Whisper 的识别能力很强,但单独用它做中文文字稿,最先遇到的问题多半是质量:OpenAI 官方文档承认它会产生“幻觉”(把没说过的话写进文字稿)、会重复输出,而且出错时不会给任何提示,整份文字稿能不能用,全靠你手动对照原音频。免费和私密是它的真实优点,这就是代价。
如果能接受这个代价,有三条路可选:不怕搭环境、要完全离线,选本地 Whisper;用 Mac、想要图形界面,选 MacWhisper(免费版可以转录,€64 一次性买断解锁高级功能);想让系统自动查错、换引擎重转、在线校对,选云端 AI 工具(例如 Subanana)。下面把三条路的差异讲清楚。
下文会用 Subanana 做对照,也会讲清楚 Whisper 和 MacWhisper 的真正强项。在某些场景下,自行部署 Whisper 确实是更好的选择。
单独使用 Whisper 的五个实际问题
每一个都能在 OpenAI 官方文档或代码里查到。
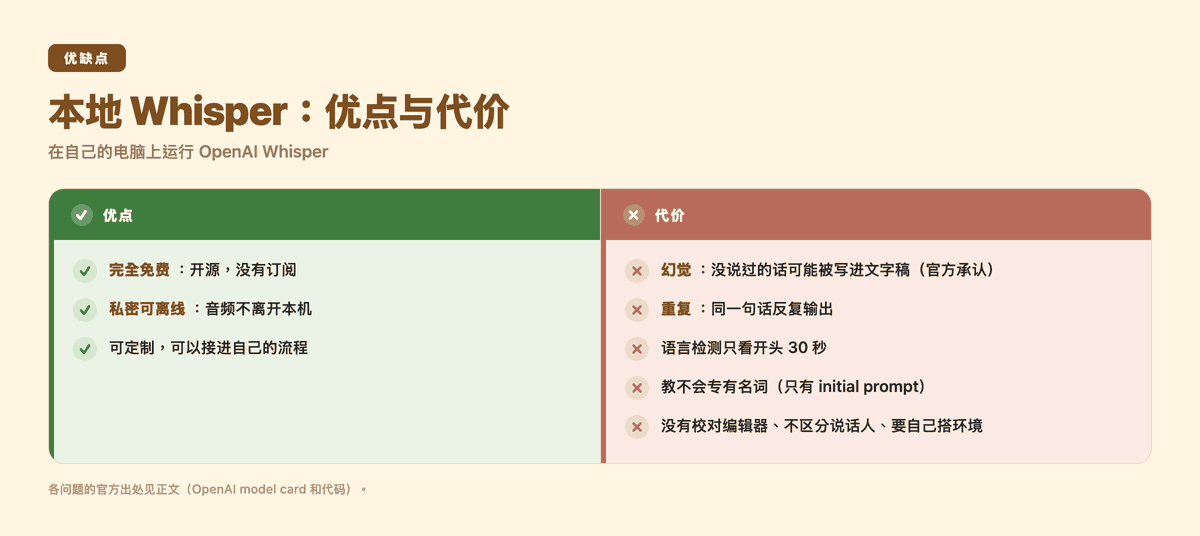
一、幻觉:没说过的话可能被写进文字稿。 OpenAI 自己的模型说明明确承认:模型输出“可能包含音频中实际没有说过的文字(即幻觉)”。原因是模型一边在“听”,一边在“按语言习惯猜下一个字”,静音和音乐片段最容易出问题。2024 年康奈尔大学团队的研究《Careless Whisper》专门记录了这类幻觉造成的实际危害。单独用 Whisper 时,没有任何机制帮你找出这些片段,你只能自己逐句对照原音频。
二、重复:同一句话反复输出。 同一份官方文档也承认,模型架构“容易产生重复的文字”,官方提供的缓解手段“能减轻,但不能完全解决”。长文件和有杂音的片段尤其常见,一旦出现,就是一整段要重听重打。
这两个问题有解,只是解法在 Whisper 之外。Subanana 的做法是对每一段输出自动做质量检查,发现疑似幻觉或重复,就改用另一个评测过的引擎重转那一段,而且重转不另外扣额度。自行部署 Whisper 时,这层质量把关就落在你自己身上。剩下三个问题也是同一个模式:模型有能力,周边没人做。
三、语言自动检测只看开头 30 秒。 代码写明自动检测“最多使用前 30 秒”判断语言,之后整个文件都按这个判断处理。开头是英文开场白、后面是中文访谈的文件,你必须知道要自己加 --language 参数。不知道的人拿到的就是一份错得莫名其妙的文字稿。
四、教不会你的专有名词。 品牌名、人名、行业术语,原版 Whisper 唯一的调整手段是 initial prompt 这个隐藏参数。每次运行都要重新给,也没有词库可以管理。写错的字,每一份文字稿都会再错一次。
五、输出不是可以直接交付的成品。 它有时间码,但字幕的断行、每行长度、一秒放几个字(观众来不来得及读)、双语对照,全都要自己处理;文字稿的标点、分段、说话人标注也一样。社区之所以长出一大圈第三方工具链,正是因为原版只给了引擎,没给周边。
这还没算上两个基本限制:每次只能选一个模型大小,在“快”和“准”之间自己取舍;大模型在没有独立显卡的电脑上明显偏慢。
换句话说,本地 Whisper 像一台发动机,还算不上整辆车。而且这台发动机出错时(幻觉、重复)不会亮任何警示灯,质量把关整层都落在你身上。
想看看有质量把关层的结果是什么样,最快的方法是拿一段自己的录音实测,免费预览不用付费:
Whisper 是什么?为什么还是有人选它?
看完五个问题还在读,说明免费和离线对你确实重要,那 Whisper 值得认真了解。它是 OpenAI 发布的语音识别模型,代码和模型权重以 MIT 许可开源,可以下载到自己的电脑上离线运行,支持多种语言,包括中文。
它的“能力分级”靠模型大小:Whisper 提供 tiny、base、small、medium、large、turbo 等多种模型,模型越大通常越准,但也越慢,越占内存和显卡。其中 tiny、base、small、medium 另有纯英文的 .en 版本,large 和 turbo 只有多语言版。处理中文这类非英文内容,一般要选较大的多语言模型,结果才比较可靠。
关键在于怎么跑起来。Whisper 本身是一个命令行工具,也可以在 Python 里调用,但运行前你得先安装 ffmpeg 这个命令行工具,并准备好 Python 和 PyTorch,用 pip 安装。这对工程师很平常;对只是想把访谈录音转成文字的研究生或内容创作者,这道门槛往往就卡住了。
Whisper 真正的强项:
- 完全免费:开源,没有订阅,不按分钟计费。用量大的人长期成本最低。
- 私密、可离线:音频不必上传到任何云端,整个转录都在你自己的机器上完成。对保密访谈和敏感内容来说,这是很实在的优势。
- 可定制:开发者能把它接进自己的流程、自行部署服务、自定义推理行为。
MacWhisper 和直接用 Whisper 有什么区别?
MacWhisper 是给 Whisper 加上 Mac 图形界面的应用:同样在你的 Mac 上用本地模型转录,主打用本地模型处理敏感文件,但你不用碰命令行,把文件拖进去就能转。它解决的正是“Whisper 难安装”这个痛点。
版本和收费(官方网站,2026 年 8 月确认):
- 免费版(€0):麦克风录音,转录常见音视频格式(mp3、wav、m4a、ogg、opus、mov、mp4),100 种语言,导出 SRT、VTT、TXT。日常轻量使用已经够了。
- Pro 版(€64,一次性买断,含终身更新):增加说话人自动识别、批量转录、YouTube 链接转录、字幕自动翻译,以及更多导出格式(.docx、.pdf、.md 等)和自动化工作流。
- 官方功能表上还有一项值得一提:会议录音(Zoom、Teams、Webex 等,直接录本机音频,不需要机器人进入会议)。对开会时顺便留文字稿的 Mac 用户是实在的加分项。
- 另有 App Store 版本“Whisper Transcription”,采用订阅制(周、月、年);直接下载的版本才是一次性买断。
所以 MacWhisper 的定位很清楚:仅限 Mac,让本地 Whisper 变得好上手,又保留离线私密;免费版能用,高级功能一次性付费买断。
本地 Whisper、MacWhisper 和云端 AI 工具怎么选?
| 对比项目 | 本地 OpenAI Whisper | MacWhisper | 云端 AI 工具(如 Subanana) |
|---|---|---|---|
| 费用 | 免费、开源 | 免费版;Pro €64 一次性买断 | 免费试用 + 付费订阅 |
| 安装门槛 | 高(需要 ffmpeg、Python) | 低(Mac 图形界面) | 无(浏览器上传即用) |
| 平台 | Windows、Mac、Linux | 仅 Mac | 任何设备,免安装 |
| 隐私 | 完全本地,可离线 | 本地,可离线 | 上传到云端处理 |
| 选模型方式 | 手动选一个模型 | 手动选模型 | 系统按内容自动选择,发现问题会自动改用别的模型重转 |
| 区分说话人 | 原生不支持 | Pro 支持 | 支持 |
| 校对编辑器 | 无 | 有 | 有(含 AI 校对建议、AI 问答) |
| 整理输出 | 纯文字输出 | 字幕、文字(Pro 有更多格式) | 自动标点分段、去除语气词,导出 SRT、VTT、TXT、DOCX、XLSX、MD |
没有绝对的赢家,只有适合你场景的选择:
- 要免费、要离线,又不怕搭环境 → 本地 Whisper。
- 用 Mac,想要好上手又保留离线私密 → MacWhisper。
- 不想安装,想要区分说话人 + 在线校对 + 自动把文字稿整理干净 → 云端 AI 工具。
Subanana 和自行部署 Whisper 的核心差别是什么?
最大的差别是:你不用自己兼任“模型管理员”和“质检员”。
它的设计正好对着上面五个问题:
| 单独用 Whisper 的问题 | Subanana 怎么处理 |
|---|---|
| 幻觉:没说过的话被写进文字稿 | 每段输出都自动做质量检查,发现疑似幻觉就改用另一个评测过的引擎重转该段,而且内部重转不扣你的额度 |
| 重复输出 | 同一层质量检查会查出来;此外还有 AI 校对层,给整份文字稿一个 0–100 的质量分数,逐句标出疑似听错、同音字和标点问题,由你逐项确认 |
| 语言要自己设对参数 | 上传时界面直接引导你选源语言,不会默默用错 |
| 教不会专有名词 | 词汇表:把品牌名、术语存进工作区或单个项目,可以用 Excel 批量导入,之后每份文字稿都认得;还可以上传背景材料,让 AI 读上下文 |
| 输出不是成品 | 自动区分说话人、加标点、分段;字幕会标出“一秒放太多字、观众来不及读”的位置;直接导出 SRT、VTT、TXT、DOCX、XLSX、Markdown、双语字幕,或一键输出烧录好字幕的视频 |
模型选择也一样:Subanana 持续评测多个语音识别引擎,按源语言和用途自动选择表现最好的模型,不绑定单一供应商。“选模型、查错、重试”这一整层工作你都不用碰。
除此之外的基本面:
- 免安装:用浏览器上传录音(或粘贴公开视频链接)就能转,任何设备都行。想直接试会议录音,可以用 AI 会议转录工具。
- 支持 95 种以上语言,除中文外也涵盖常见语言和翻译,而且翻译目前不另外扣额度。
代价是 Subanana 的转录在云端进行,音频会上传处理。如果你的内容规定“绝对不能离开本机”,本地 Whisper 或 MacWhisper 仍然更合适。
常见问题(FAQ)
Whisper 做中文文字稿准吗? 选较大的多语言模型时,整体识别能力不错,但准确不等于可靠:官方文档承认输出可能包含音频中没说过的字(幻觉)和重复片段,而单独使用时没有机制提醒你哪里出错。加上不区分说话人、不整理标点分段,重要引用一定要对照原音频校对。
Whisper 完全免费吗? 本地 OpenAI Whisper 是开源免费的。MacWhisper 免费版可以转录和导出 SRT、VTT、TXT;说话人识别、批量转录等高级功能需要 Pro(€64 一次性买断)。云端工具大多是免费试用 + 付费订阅。
不会写代码,可以用 Whisper 吗? 直接用原版 Whisper 需要安装 ffmpeg 和 Python,对非技术用户门槛偏高。Mac 用户可以改用 MacWhisper(图形界面);想完全免安装,就选浏览器上传的云端工具。
在意隐私,一定要用本地 Whisper 吗? 如果规定内容不能离开本机,本地 Whisper 或 MacWhisper(两者都可离线)最合适。云端工具会把音频上传处理,用方便换来了“内容离开本机”这一点,按你的合规要求取舍。
Subanana 用的是 Whisper 吗? Subanana 不绑定任何单一供应商,它持续评测多个语音识别引擎,按内容自动选择最合适的,并在发现问题时自动改用其他模型重转。每一段都会路由到当前评测最佳的引擎,你不用关心具体是哪一家。
想跳过安装和选模型,上传就拿到分好说话人、整理干净的文字稿?