
访谈文字稿的核心需求其实只有三个:文字要准、要分得清谁说了哪句、要能直接拿来引用。如果你做的是定性研究、UX 访谈、新闻采访,或者只是学生在交报告,一份大概的记录并不够用,你需要的文字稿要能逐句编码,也能引述进论文或报道。
做法主要有三种:人工听打、免费自动字幕工具、AI 语音转文字。本教程会说明三者的取舍,并示范如何用 Subanana 的**“文字稿与笔记”模式**,把一段访谈录音转成带说话人标记、有标点、有分段的文字稿,把后续人工整理的时间压到最低。AI 转录负责处理大部分听打的苦活,你只需要做最后一轮校对。
访谈文字稿和字幕有什么区别?
很多人第一次找工具时,会把“字幕”和“文字稿”混为一谈,结果拿到不合用的文件。两者其实是两件事:
- 字幕(subtitles) 是给视频画面看的,按时间切成一行行短句,惯例上不加标点,输出 SRT、VTT 等文件。
- 文字稿(transcript) 是给人读的,要有标点、有段落、分得清说话人,方便你一段段往下读、做标注、提取引述。
访谈文字稿属于后者。所以在工具里选错模式,用“字幕与翻译”模式去做访谈,你会得到一堆按时间切碎、没有标点的短句,反而更难用。这也是下文一直强调“要选“文字稿与笔记”模式”的原因。
三种做法的取舍
做法一:人工听打
最传统,也是准确度上限最高的做法,你亲自一句句听、一句句打。
- 优点:你完全掌握每个字,连语气、停顿、重叠发言都可以按研究需要标注。
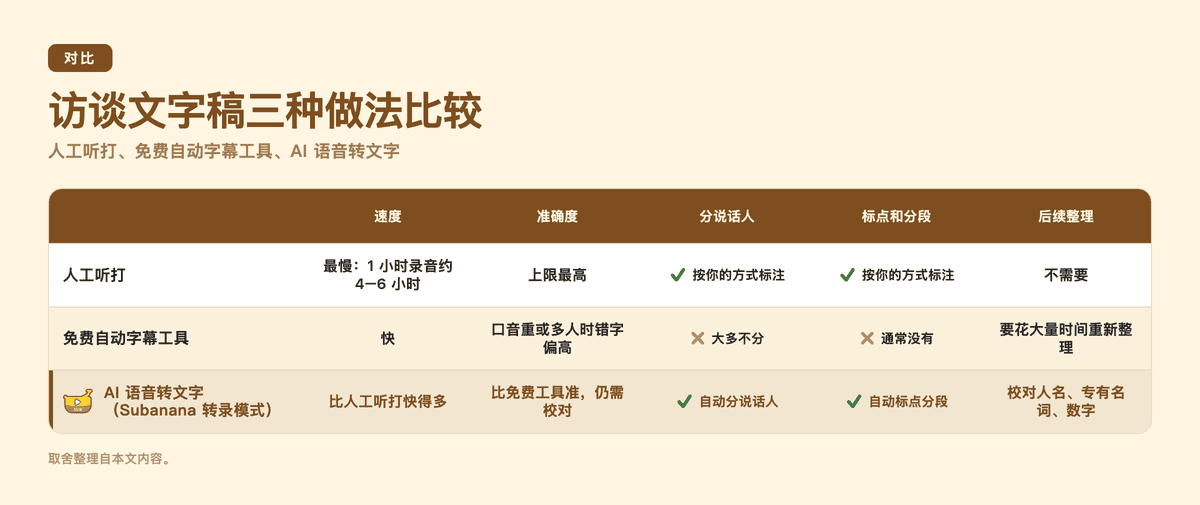
- 局限:极慢。业内常见的经验值是一小时录音要花四到六小时听打,多人访谈、口音重、收音差的情况更慢。对要赶截止时间的记者或同时跑多场访谈的研究者来说,时间成本往往无法承担。
做法二:免费自动字幕工具
不少免费工具(例如视频平台的自动字幕、在线转文字网站)可以快速生成文字。
- 优点:快、免费、门槛低。
- 局限:对口音较重或多人交谈的内容,错字率明显偏高;大多不分说话人,整段访谈的文字混在一起,分不清谁说了哪句;通常没有标点和分段,读起来像一堵文字墙。对英文短内容还算够用,对要拿去引用的中文访谈,往往要再花大量时间重新整理。
做法三:AI 语音转文字工具
如果你要的是“拿到文字稿就能读、能引用”的质量,AI 转录是目前最务实的折中做法。工具用语音识别模型重新转录一次,并做标点、分段、说话人识别,再让你在编辑器里校对。
- 优点:比人工听打快得多;比免费工具准,而且会自动分说话人、加标点分段。
- 取舍:AI 转录不会取代最后的校对。要逐字引用受访者原话之前,你仍然应该做一轮人工校对,核对人名、专有名词、关键数字。准确度高不等于零错误;引用的分量越重,越值得校对。
下一节示范如何用 Subanana 走第三条路。
怎么用 Subanana 把访谈录音转成文字稿?
Subanana 在访谈文字稿这个场景的重点是:说话人识别(diarization)、自动去除语气词、自动标点和分段。
关键的第一步是选对模式。Subanana 分“字幕与翻译”模式、“文字稿与笔记”模式、“会议笔记”模式,访谈文字稿要选**“文字稿与笔记”模式**,它才会自动加标点、按语义分段,生成可阅读的文字稿;“字幕与翻译”模式只会给你按时间切碎的字幕行。整个流程分四步:
- 导入录音:上传访谈的音频或视频文件(支持 .mp4、.mov、.webm、.ogg 等格式),或者粘贴公开的 YouTube、Instagram、Facebook 链接直接导入。如果访谈放在私人链接或受权限保护的视频里,请改用文件上传。(还没录音、打算用 Mac 录的话,可以先看 Mac 自带录音的三种方法。)
- 选“文字稿与笔记”模式并设置源语言:进入“文字稿与笔记”模式,选择录音的源语言。Subanana 涵盖 95+ 种语言。把说话人人数设为自动检测(或手动输入人数);自动标点和分段是“文字稿与笔记”模式的内置行为,不用另外打开。
- 校对和标记说话人:转录完成后进入编辑器。系统会自动把不同说话人分成 Speaker 1、Speaker 2,并去除“嗯”“就是”这类语气词、整理文字。你可以做这些事:
- 改说话人名称:把 Speaker 1 改成“主持人”、Speaker 2 改成“受访者 A”,整份文字稿会同步更新,方便日后逐句引用标注。
- 修正错字:点击文字直接修改。人名、机构名、专业术语这类最容易出错的词,建议先设置词汇表(Glossary),系统转录时会优先采用你指定的写法。
- 和文字稿对话:在编辑器内可以直接问 AI,例如“受访者 A 在哪一段提到 X”“帮我提取三个关键论点”,对长访谈的整理特别省时。
- 导出:选择你需要的格式。文字稿用途最常用 DOCX(Word,直接编辑)或 TXT(粘贴进 Obsidian、Notion 等笔记软件);要做引用标注或编码,可以选 XLSX,把时间码、说话人、文字做成表格。也支持 VTT、SRT、Markdown。
校对好、导出文件,这份访谈文字稿就能直接放进你的论文、报道或分析里。想了解模式设计,可以参考 AI 字幕和转录工具和 AI 会议记录。
中文访谈特别要注意什么?
中文访谈正是不少通用语音工具最弱的一环。挑工具时值得留意两点:
- 中文的识别质量:中文同音字多、人名和专有名词密集,免费通用工具错字率偏高,而这些字偏偏是你最需要引用准确的地方。Subanana 持续评测各语音识别模型,为每种源语言挑选表现最好的一个,不绑定单一供应商;转录出问题时还会自动换另一个模型重新运行,重新运行不额外扣你的分钟额度。
- 说话人识别省下的整理时间:多人座谈、焦点小组访谈最麻烦的就是分不清谁说了哪句。“文字稿与笔记”模式会自动分出说话人并让你重新命名,省掉你回头一句句标记发言者的功夫,这对后续编码和引用标注特别关键。
要提一点界线:跨语言处理上,“一句话里中英来回混杂、实时自动切换”这种场景是 Subanana 实时字幕功能的强项,不在“文字稿与笔记”模式的范围内。访谈文字稿这边,你要依靠的是中文识别质量和说话人识别,句中实时语言切换帮不上忙。需要现场实时字幕的活动场景,可以参考 AI 实时语音转字幕。
访谈文字稿常见问题
免费方案能做完整份访谈文字稿吗?
可以试做、预览结果,但导出要付费。免费方案不支持字幕和文字稿文件下载,也不能在编辑器选取复制文字,输出仅限带水印、最长 15 秒、720p 的视频和 Word、Markdown 格式的 AI 摘要。要导出 DOCX、TXT、XLSX 等可用的文字稿文件,需要付费方案。
多人访谈分得清谁说了哪句吗?
可以。“文字稿与笔记”模式支持说话人识别,会自动分出 Speaker 1、Speaker 2 等标记,你在编辑器内可以改成实际角色(主持人、受访者 A),整份文字稿会同步更新。
AI 转录出来的文字稿可以直接引用吗?
建议先做一轮人工校对再引用。AI 转录把绝大部分文字和分段处理好,但人名、专有名词、关键数字这些“引错就出事”的地方,值得你逐句核对,尤其是要直接引述受访者原话的段落。
访谈录音文件很长(一两小时)也可以吗?
可以。一般访谈录音都在范围内。长访谈更建议先用编辑器内的 AI 对话功能找出重点段落,再针对要引用的部分细校。