
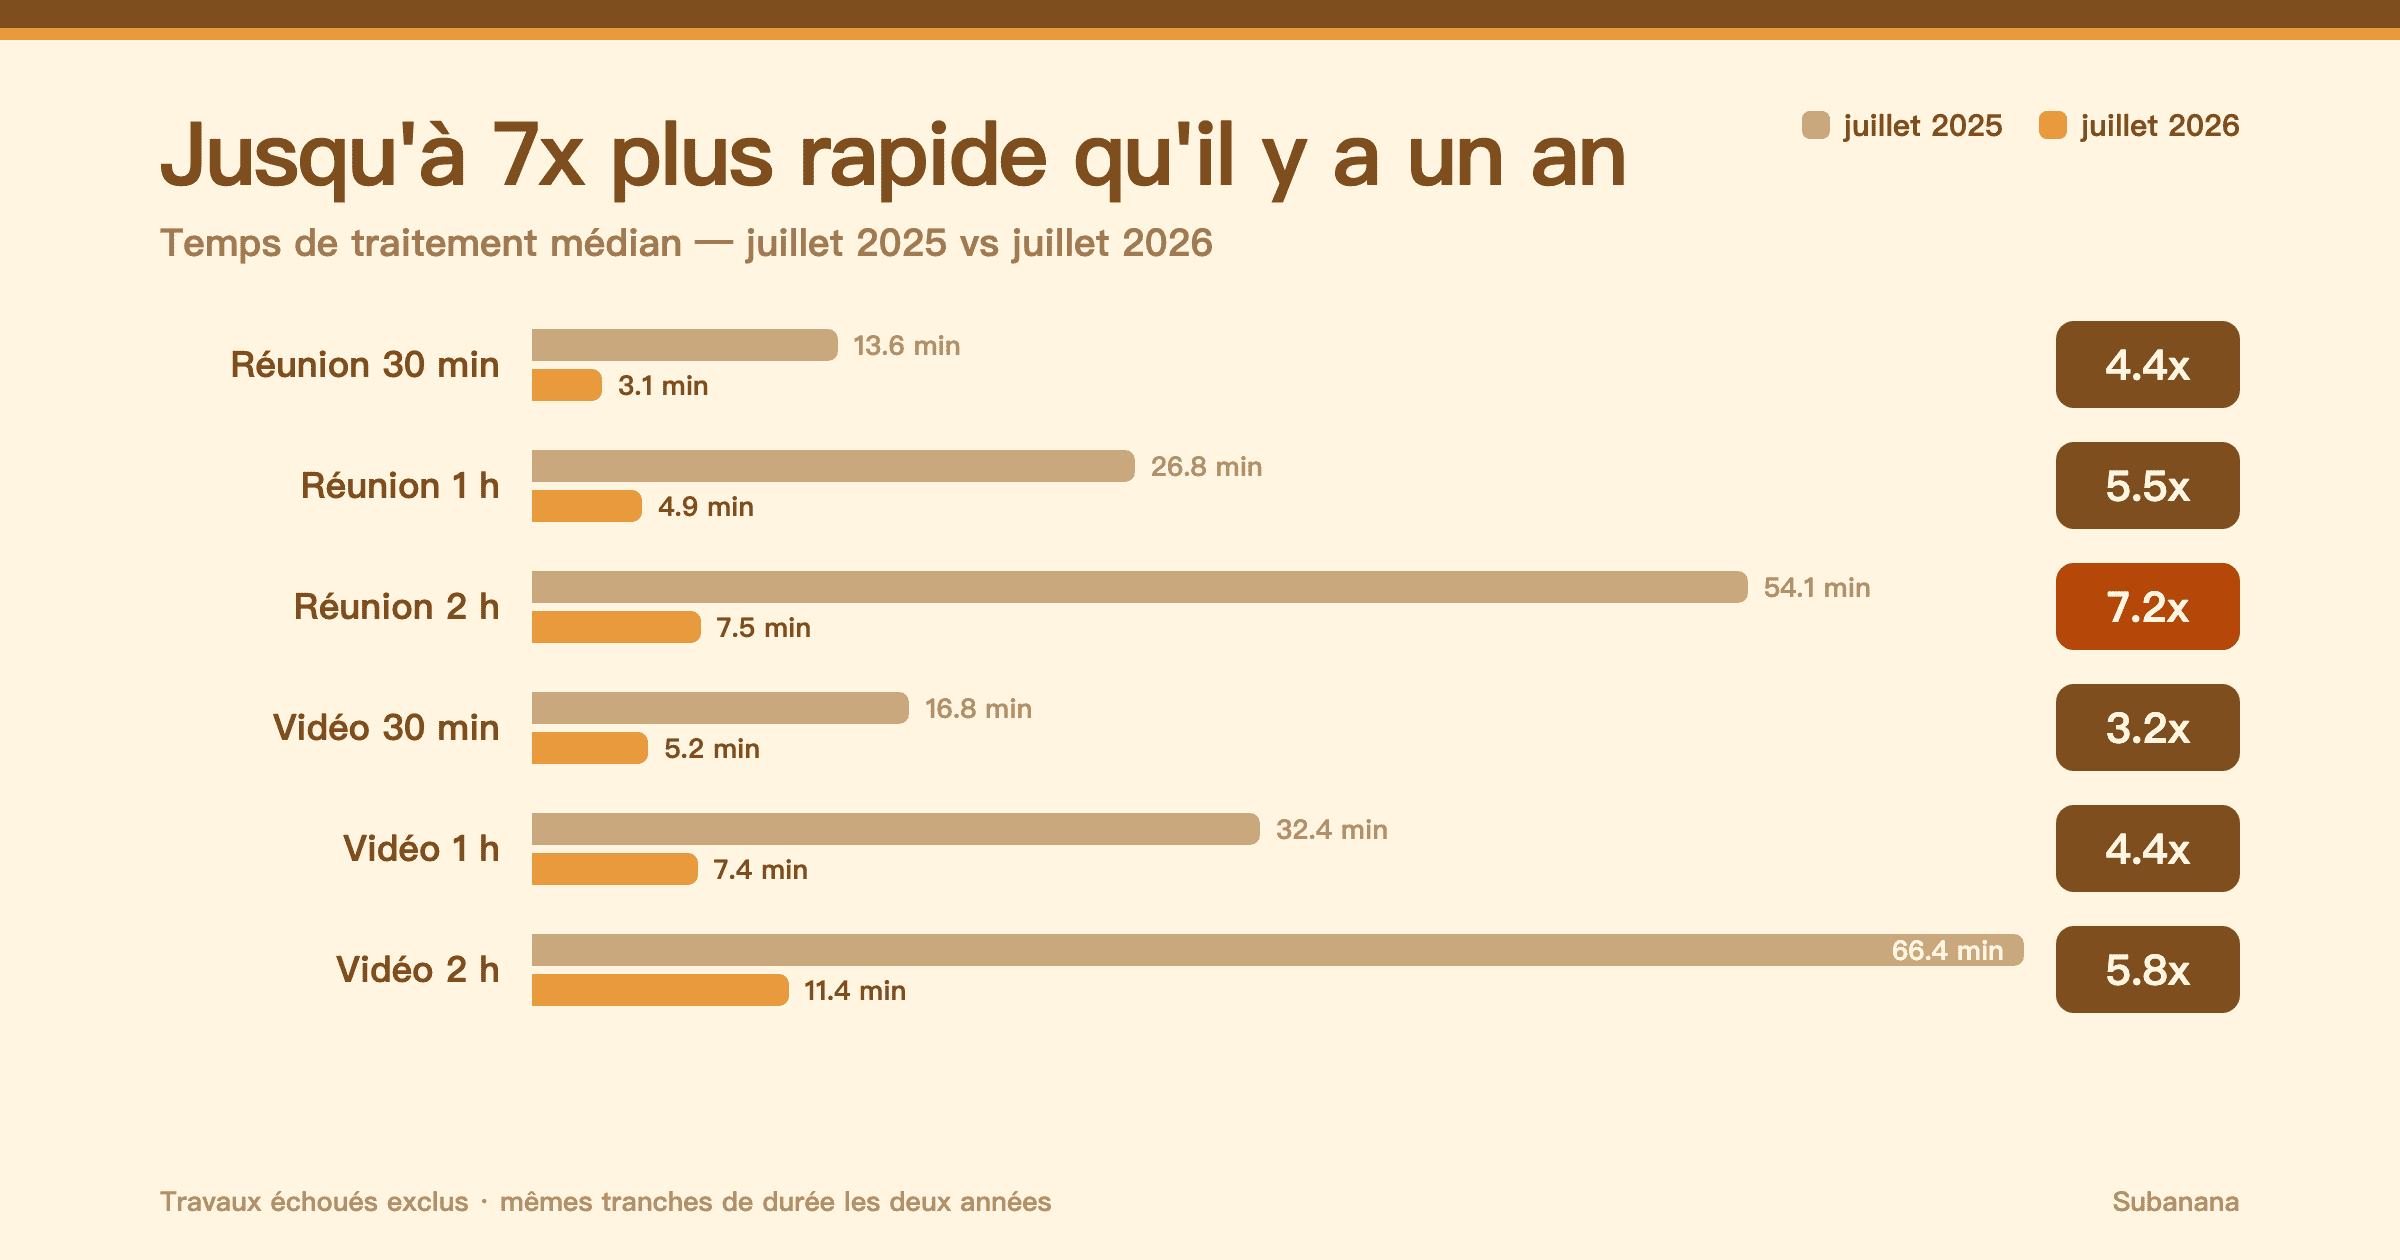
En juillet 2025, le traitement d'un enregistrement de réunion d'une heure prenait 26.8 minutes.
Ce mois-ci, le même travail prend 4.9 minutes.
Ce n'est pas un benchmark conçu pour flatter. C'est la médiane de nos temps de traitement pour les réunions d'une heure sur chacun de ces deux mois de juillet — pas un fichier de démo trié sur le volet — les travaux échoués étant exclus des deux côtés. Même mois de l'année, mêmes durées de fichiers, même méthode de mesure. Environ cinq fois et demie plus rapide — et les fichiers longs ont gagné encore davantage.
Personne n'a sorti de version « tout est plus rapide ». C'est un an de travail discret sur les parties du pipeline dont personne ne parle dans les blogs, et cela s'est accumulé.
Ce qui a réellement changé
Médiane des temps de traitement, juillet 2025 contre juillet 2026. Le second nombre de chaque cellule est le dixième le plus lent — le travail sur dix qui prend le plus de temps. Les médianes flattent ; ce sont les queues de distribution qui montrent à quoi ressemble une mauvaise journée.
| Travail | Juillet 2025 | Juillet 2026 | Gain |
|---|---|---|---|
| Réunion 30 min | 13.6 min (p90 26.4) | 3.1 min (p90 5.9) | 4.4x |
| Réunion 1 h | 26.8 min (p90 61.9) | 4.9 min (p90 6.8) | 5.5x |
| Réunion 2 h | 54.1 min (p90 120.9) | 7.5 min (p90 13.4) | 7.2x |
| Vidéo 30 min | 16.8 min (p90 35.6) | 5.2 min (p90 12.1) | 3.2x |
| Vidéo 1 h | 32.4 min (p90 136.4) | 7.4 min (p90 21.0) | 4.4x |
| Vidéo 2 h | 66.4 min (p90 147.3) | 11.4 min (p90 28.9) | 5.8x |
Les queues de distribution ont progressé encore plus que la médiane, et c'est cela qui compte. Il y a un an, une réunion d'une heure sur dix mettait plus d'une heure à revenir. Aujourd'hui, le dixième le plus lent commence à sept minutes — un mauvais traitement d'aujourd'hui est plusieurs fois plus rapide qu'un traitement typique d'alors. Le pire cas pour une vidéo d'une heure est passé de plus de deux heures à 21 minutes. Si vous aviez discrètement prévu de la marge dans votre agenda à cause de Subanana, vous pouvez arrêter.
Ce sont les fichiers longs qui ont le plus gagné — le 7x se trouve sur la ligne « Réunion 2 h ». C'est l'inverse de ce qui arrive d'habitude quand un pipeline est optimisé sur de courts clips de démo, et cette différence change les usages : une attente d'une heure et demie est un travail « je reviens après déjeuner » ; sept minutes, c'est un travail « je reste devant l'écran ».
Et la tendance ne fléchit pas : la dernière semaine de juillet a été la plus rapide de l'histoire de Subanana, avec une médiane de 5.5 minutes pour les vidéos d'une heure.
Ce qui m'a surpris
Voici comment se répartit aujourd'hui l'attente pour une vidéo d'une heure. Les étapes se chevauchent : lisez des proportions approximatives, pas une séquence stricte.
| Étape | Part de l'attente |
|---|---|
| File d'attente | ~7% |
| Acheminement du fichier dans le pipeline | ~2% |
| Préparation des médias (audio, forme d'onde) | ~25% |
| Transcription | ~20% |
| Création et vérification des sous-titres | ~16% |
| Rendu de l'aperçu que vous parcourez ensuite | ~29% |
La transcription — la partie IA — représente environ un cinquième de l'attente.
L'IA n'a jamais été le goulot d'étranglement. Tout le monde croit que la reconnaissance vocale est l'étape lente, parce que c'est celle qui contient le modèle. Ce n'est pas le cas, et depuis longtemps. Environ quatre cinquièmes de votre attente relèvent de la logistique : décoder le fichier, extraire une piste audio propre, générer la forme d'onde, rendre l'aperçu dont l'éditeur a besoin pour que vous puissiez parcourir le résultat.
C'est exactement pour cela que les gains sont venus d'où ils sont venus. Le seul acheminement du fichier dans le pipeline a gagné plus de 90% depuis juin, et la préparation des médias a été à peu près divisée par deux. Il n'y avait presque rien à gagner sur la transcription. Il y avait beaucoup à gagner sur tout le reste.
Trois choses utiles découlent de ce tableau :
Les réunions reviennent le plus vite. Un travail de réunion saute entièrement le rendu de l'aperçu vidéo — une grande partie de la raison pour laquelle les lignes « réunion » devancent toujours les lignes « vidéo » à durée égale.
Ajouter une traduction ne retarde pas vos résultats. La traduction s'exécute de manière asynchrone — la transcription et les sous-titres en langue originale arrivent aussi vite qu'avant, et la piste traduite suit d'elle-même. Si vous omettiez la traduction pour préserver votre délai, ce n'est pas nécessaire. En mode sous-titres, un même travail peut recevoir plusieurs langues cibles.
Votre upload n'est pas compté dans ces chiffres. Le chrono démarre au début du traitement, une fois votre fichier arrivé. Avec une connexion lente, l'upload peut représenter la moitié la plus longue de votre attente. Si la vidéo est déjà publique, collez un lien YouTube, Instagram ou Facebook et sautez l'upload — Subanana va la chercher directement.
La partie qu'on ne peut pas contourner
N'importe qui peut louer un bon modèle de reconnaissance vocale. C'est le secret de Polichinelle de cette catégorie — l'IA, la partie auréolée de mystère, est accessible à quiconque demande une clé API. C'est pourquoi une nouvelle application de transcription apparaît chaque semaine.
Mais le modèle ne représente qu'un cinquième de votre attente. Les quatre autres cinquièmes, c'est la machinerie qui l'entoure : ingestion, décodage, extraction audio, création des sous-titres, rendu de l'aperçu, gestion des files. Rien de tout cela ne se loue. Il faut le construire, le mesurer sur de vraies charges de travail, le reconstruire — et la seule façon de l'accélérer est d'investir du temps d'ingénierie dans des problèmes qu'aucune démo ne fait jamais apparaître.
C'est exactement ce qui s'est passé cette année. Pas une grosse version, pas un changement de modèle chanceux : l'accélération s'est accumulée presque chaque mois depuis un an et demi. Une application-coquille assemblée en un week-end peut utiliser la même transcription que nous. Les quatre cinquièmes, elle ne peut pas les répliquer — et c'est précisément ce que vous ressentez à chaque long fichier envoyé.
Ce qui ne change pas
Les reprises restent gratuites. Quand une transcription semble défaillante, le système renvoie automatiquement les segments concernés vers un autre modèle, en arrière-plan, sans vous prévenir. Le second passage n'est pas facturé — vous payez le fichier une fois, quel que soit le nombre de tentatives internes. C'était vrai il y a un an, c'est vrai aujourd'hui ; c'est juste plus rapide.
Les limites par fichier ont depuis été relevées à 8 heures et 30 Go, et elles sont désormais les mêmes sur toutes les formules ; sur la formule gratuite, seules 15 minutes par fichier sont transcrites.
Essayez avec un fichier long
Si vous repoussiez un enregistrement de deux heures pour ne pas y perdre une heure, le calcul a changé. C'est environ onze minutes désormais.
Transcription de réunion par IA et sous-titrage par IA tournent tous deux sur le pipeline d'où viennent ces chiffres.
Tous les chiffres sont des médianes de temps de traitement — juillet 2025 (mois complet) contre le 1er–27 juillet 2026 — groupées par durée source, travaux échoués exclus, mesurées à partir du début du traitement. Les lignes « 2 h » couvrent les fichiers de 90 minutes à 3 heures. Vos temps varieront selon la taille du fichier, le codec et la charge.