발표 녹음을 텍스트로 바꾸는 가장 빠른 방법은: 녹음 파일(또는 영상 파일)을 음성 텍스트 변환 도구에 올리고, 발표 언어를 지정한 뒤, 변환된 텍스트를 AI 요약으로 정리하는 것입니다. Subanana 같은 도구를 쓰면 이 세 단계가 한 화면에서 끝나고, 질의응답 구간은 화자별로 구분되어 나옵니다.
문제는 그다음입니다. 컨퍼런스 발표나 피칭 리허설, 사내 발표 녹음은 일반 회의 녹음과 다른 데가 있습니다. 발표자 한 명이 길게 말하다가 질의응답에서 여러 사람이 끼어들고, 슬라이드에 나온 고유명사·전문용어가 반복되고, 발표 중간에 영어 용어가 섞이는 경우도 흔합니다. 그냥 아무 변환 도구에 넣는다고 끝나지 않는 이유입니다.
발표 녹음이 유독 까다로운 이유
일반 회의 녹음과 비교했을 때 발표 녹음에는 세 가지 특징이 있습니다.
- 발화 구조가 비대칭적입니다. 발표자 한 명이 10~40분을 혼자 말하다가, 질의응답에서 갑자기 여러 목소리가 짧게 오갑니다. 화자 구분이 안 되는 도구로 변환하면 질의응답 구간이 누가 무슨 말을 했는지 알 수 없는 텍스트 뭉치가 됩니다.
- 전문용어·고유명사 밀도가 높습니다. 제품명, 프로젝트 코드명, 업계 용어가 슬라이드마다 반복되는데, 발음이 조금만 부정확해도 매번 다르게 잘못 인식될 수 있습니다.
- 리허설이면 본인 목소리를 스스로 녹음해야 합니다. 컨퍼런스 현장 녹음과 달리, 피칭 리허설이나 발표 연습은 외부 녹음기 없이 노트북 앞에서 바로 녹음하는 경우가 많습니다.
이 세 가지를 염두에 두고 녹음 방법과 변환 흐름을 나누면 결과물의 질이 크게 달라집니다.
발표 녹음하는 방법
컨퍼런스·세미나 현장에서
스마트폰 녹음 앱이면 충분하지만, 발표장이 넓거나 뒷자리라면 무대 스피커에서 나오는 소리보다 주변 소음이 더 크게 잡힐 수 있습니다. 가능하면 앞쪽 자리에 앉거나, 발표자 근처에 녹음기를 둘 수 있는 경우 그렇게 하는 편이 변환 정확도에 유리합니다. 질의응답 시간에는 질문자가 마이크를 쓰지 않는 경우가 많아 소리가 작아지므로, 이 구간에서 녹음기를 발표자와 청중 사이 중간 지점으로 옮기는 것도 방법입니다.
피칭·발표 리허설을 혼자 연습할 때
이 경우는 외부 녹음기가 필요 없습니다. Subanana는 브라우저에서 바로 마이크 녹음과 화면(탭) 녹음을 지원하며, 무료 플랜에서도 쓸 수 있는 기능입니다. 슬라이드를 화면에 띄운 채로 발표 연습을 하면서 화면 녹화를 켜면, 발표 내용과 슬라이드 타이밍이 함께 기록됩니다.
웨비나·화상회의로 진행되는 발표
구글 미트나 마이크로소프트 팀즈로 진행되는 사내 발표라면, 캘린더 연동 봇이 자동으로 참여해 녹화하고 회의가 끝난 뒤 변환·요약까지 이어집니다(사후 처리이며 실시간 자막은 아닙니다. Zoom 전용 봇은 없습니다). Zoom으로 진행된 발표는 녹화 파일을 그대로 올리면 다음 단계로 넘어갑니다.
녹음을 정리된 발표 노트로 바꾸기
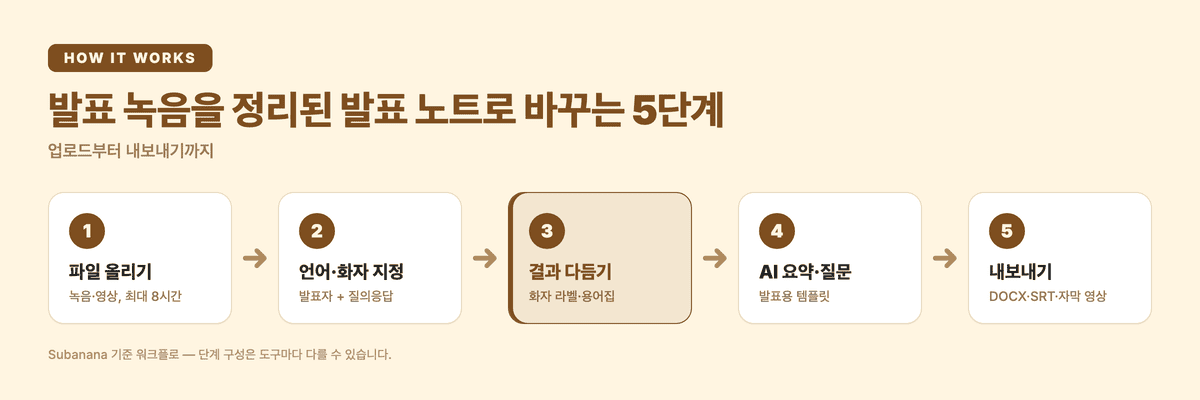
녹음(또는 영상) 파일이 준비됐다면 텍스트 변환 도구에 올릴 차례입니다. Subanana에서는 이렇게 이어집니다.
- 파일 올리기. plus.subanana.com에서 녹음 파일이나 발표 영상을 드래그해 올립니다. 파일당 최대 8시간·30GB까지 지원되며(전 플랜 동일), 유튜브에 올라온 공개 발표 영상이라면 링크만 붙여넣어도 가져와서 변환합니다.
- 언어·화자 지정. 발표 언어를 고르고, 화자 수를 자동 또는 수동으로 지정합니다. 발표자 한 명 + 질의응답 여러 명 구조라면 화자 구분을 켜 두는 편이 좋습니다. 질의응답에서 "누가 이 질문을 했는지"가 나중에 훨씬 잘 보입니다. 기본(Standard) 모드는 파일 전체에 언어 하나를 적용하므로, 슬라이드 속 영어 제품명 정도가 섞이는 수준이면 발표의 주 언어만 고르면 됩니다. 반대로 질의응답 전체가 영어로 진행되는 등 언어가 구간별로 뚜렷하게 나뉜다면, 유료 Enhanced(다국어) 모드에서 최대 10개 언어를 지정할 수 있습니다(일반 변환보다 처리 분량이 더 차감됩니다). 다만 이 모드에서도 문장 단위로 완벽하게 원어 그대로 보존된다고 보장하지는 않으므로, 변환 후 해당 구간은 한 번 더 확인하는 것이 안전합니다. 번역이 필요하면 번역 언어를 함께 지정할 수 있습니다.
- 변환 결과 다듬기. 변환이 끝나면 문장부호와 문단이 자동으로 정리된 텍스트가 나옵니다(이 자동 정리는 끌 수 없는 기본 동작입니다). 화자 라벨을 확인해 이름으로 바꾸고, 발음이 부정확해 잘못 인식된 단어(오탈자·동음이의어)가 있으면 제안된 교정을 확인해 적용하거나 거부합니다. 발표에서 반복되는 제품명·프로젝트명은 용어집에 미리 등록해 두면 다음 발표부터 더 정확하게 인식되며, 워크스페이스 전체에 적용되는 목록과 이 발표에만 쓰는 목록을 따로 관리할 수 있고, 여러 단어를 한 번에 엑셀·CSV로 등록할 수도 있습니다. 발표 슬라이드나 관련 자료(PDF·문서)를 배경 자료로 올려 두면 변환·요약이 그 맥락을 참고합니다.
- AI로 요약·질문. 변환된 텍스트에서 핵심 내용과 결론을 뽑는 요약 템플릿을 고릅니다(발표·강연용 템플릿 포함 30종 이상). 편집기 안에서 "질의응답에서 나온 질문이 뭐였지?", "발표자가 일정에 대해 뭐라고 했지?" 같은 질문을 바로 던지면 녹취록을 근거로 답을 찾아 줍니다. 다시 녹음을 처음부터 들을 필요가 없습니다.
- 정리본 내보내기. 결과는 DOCX(워드), TXT, XLSX(엑셀), SRT·VTT(자막) 등으로 내보낼 수 있습니다. 발표 영상 자체에 자막을 입혀 사내 공유용으로 만들고 싶다면, 자막 모드로 변환한 뒤 자막을 입힌 영상으로 출력하는 방법도 있습니다.
클로바노트로는 안 되나요?
네이버 클로바노트는 한국어 개인 기록용으로 무료 제공량이 넉넉해 월 300분, 데이터 활용에 동의하면 600분까지 무료입니다. 순수 한국어 발표를 짧게 녹음해 개인적으로 다시 읽어보는 정도라면 클로바노트로 충분할 수 있습니다.
다만 발표 녹음 특성상 몇 가지 구조적 한계에 부딪히기 쉽습니다. 클로바노트는 음성 파일(.m4a·.mp3·.aac·.amr·.wav)만 업로드할 수 있고 영상 파일은 받지 않으므로, 웨비나 녹화본이나 유튜브에 올라온 발표 영상은 오디오를 따로 추출해야 합니다. 파일 하나당 녹음 시간은 180분으로 제한돼 있어 긴 기조연설이나 워크숍 세션은 나눠서 올려야 할 수 있습니다. AI 요약은 인식 언어가 한국어인 노트에서만 월 15회 제공되므로, 영어 발표나 영어 용어가 많이 섞인 발표는 요약이 지원되지 않습니다. 이런 지점들은 무료 개인 기록 도구로서의 설계 범위이며, 발표·강연처럼 영상 파일·영어 혼용·화자 다수가 겹치는 용도에서는 벽으로 작동합니다.
Subanana는 영상 파일을 그대로 받고, 언어가 구간별로 뚜렷이 나뉘는 발표라면 유료 다국어 모드로 처리할 수 있으며, 화자 구분과 요약을 발표·강연용 템플릿으로 지원합니다. 다만 Subanana도 사용량 기반 유료 플랜이며 무제한 처리는 제공하지 않는다는 점은 분명히 해 둡니다. 무료 플랜은 파일당 처음 15분까지 미리보기만 가능하고 내보내기는 되지 않으며, 정리된 텍스트·요약을 실제로 받으려면 유료 플랜이 필요합니다. 연간 결제 기준 Lite 플랜이 월 US$9(월 60분)부터 시작합니다. 자세한 구성은 요금제 페이지에서 확인할 수 있습니다.
자주 묻는 질문
발표장 소음이 있어도 텍스트 변환이 잘 되나요?
정확도는 녹음 음질에 크게 좌우됩니다. 발표자 목소리가 마이크를 통해 스피커로 나오는 환경이라면 스마트폰을 앞쪽 자리에 두는 것만으로도 품질이 크게 좋아집니다. Subanana는 언어별로 성능이 좋은 인식 모델로 자동 라우팅하고, 인식 결과에 문제가 의심되는 구간은 다른 모델로 다시 처리하는 과정을 거치므로 다소 시끄러운 환경에서도 검토 가능한 수준의 결과를 목표로 합니다. 그래도 잡음이 심한 녹음은 변환 후 검토가 더 필요합니다.
질의응답 시간처럼 여러 명이 말할 때 화자 구분이 되나요?
네. 화자 구분(자동 또는 수동)을 지원하므로 발표자와 질문자를 구분해 텍스트가 나옵니다. 화자 수를 미리 알고 있다면 수동으로 지정해 두는 편이 더 정확합니다. 다만 여러 명이 동시에 말하거나 겹쳐 말하는 구간은 어떤 도구를 쓰든 완벽하게 분리되지 않을 수 있어, 이런 구간은 변환 후 눈으로 한 번 확인하는 것이 안전합니다.
발표 중에 영어 용어가 섞여 나와도 인식되나요?
기본 모드는 파일 전체에 언어 하나를 적용하므로, 발표 언어와 다른 언어로 된 구간은 지정한 발표 언어로 옮겨져 나올 수 있습니다. 단어 단위로 원어 그대로 보존된다고 보장하지는 않습니다. 슬라이드에 반복되는 영어 제품명·프로젝트명 정도는 용어집에 미리 등록해 두면 매번 같은 표기로 나오도록 도와줍니다. 질의응답 전체가 다른 언어로 진행되는 등 구간이 뚜렷하게 나뉜다면, 유료 Enhanced(다국어) 모드에서 최대 10개 언어를 지정하는 편이 결과가 더 낫습니다.
정리된 발표 노트는 어떤 형식으로 받을 수 있나요?
텍스트·요약은 DOCX, TXT, XLSX, Markdown으로 내보낼 수 있고, 자막이 필요하면 SRT·VTT로, 발표 영상 자체에 자막을 입힌 영상으로도 출력할 수 있습니다. 이 목록 밖의 자막 파일 형식이나 HWP(한글 워드프로세서) 형식은 지원하지 않습니다. 한글 파일 제출이 꼭 필요한 경우라면 이 부분을 먼저 확인하는 것이 좋습니다.
정리
발표 녹음의 목적은 녹음 파일을 쌓아 두는 게 아니라, 나중에 그대로 참고할 수 있는 정리된 발표 노트를 얻는 것입니다. 컨퍼런스 발표든 피칭 리허설이든 사내 발표든, 녹음(또는 화면 녹화) → 화자·언어 지정 → 변환 결과 다듬기 → AI 요약·질문 → 내보내기의 흐름은 같습니다. 발표자 한 명 + 여러 명의 질의응답이라는 구조가 반복된다면, 화자 구분과 발표용 요약 템플릿을 지원하는 도구를 쓰는 편이 결과물의 완성도를 크게 바꿉니다.