여러 명이 참여한 회의나 인터뷰 음성을 텍스트로 변환(STT)하고 나면 늘 마주하는 문제가 있습니다. 바로 "누가 어떤 말을 했는지" 구분이 안 된다는 점입니다. 녹음본을 실무에서 바로 쓸 수 있는 회의록이나 녹취록으로 완성하려면, 목소리의 특징을 분석해 "참석자 A: …", "참석자 B: …" 형태로 발언자를 나누어 주는 화자 분리(Speaker Diarization) 기술이 반드시 필요합니다.
이번 글에서는 화자 분리의 기본 원리부터 인식 오류가 발생하는 원인, 녹음 단계에서 정확도를 끌어올리는 팁, 그리고 실무에서 선택할 수 있는 3가지 접근 방식을 정리해 드립니다. 글 마지막에는 웹 기반 AI 회의록 도구인 Subanana로 화자별 회의록을 만드는 방법과, 어떤 상황에는 맞지 않는지도 가감 없이 적었습니다.
화자 분리와 음성 인식(STT)은 무엇이 다른가요?
- 음성 텍스트 변환(STT): "무엇을 말했는가"를 처리합니다. 오디오 신호를 텍스트 문장으로 바꿉니다.
- 화자 분리(Diarization): "누가, 언제 말했는가"를 처리합니다. 음성의 고유한 특징을 분석해 발언자가 바뀌는 지점을 감지하고, 각 구간을 특정 발언자에게 연결합니다.
Google Cloud의 음성 인식 문서에 따르면, 화자 분리는 음성 인식 요청에서 독립적으로 설정되는 매개변수입니다. 시스템은 발화자의 전환 시점을 감지하고, 오디오에서 식별된 각 목소리에 번호(인덱스)를 부여합니다. 즉, 텍스트 변환 작업 위에 한 겹의 처리 과정이 더 얹어지는 구조입니다. 두 작업이 모두 깔끔하게 처리되어야 비로소 "사람별로 깔끔하게 정리된 회의록"이 완성됩니다.
회의록, 인터뷰 녹취록, 다자간 팟캐스트 등 둘 이상의 목소리가 섞인 오디오는 화자 분리가 적용되었는지에 따라 결과물의 활용도에서 큰 차이가 납니다.
화자 분리 오류는 왜 생길까요?
화자 분리 알고리즘도 완벽하지는 않습니다. 다음과 같은 환경에서는 화자가 뒤바뀌거나 한 사람이 둘로 나뉘는 오류가 발생하기 쉽습니다.
- 발언 중첩(동시 발화): 다른 사람의 말에 맞장구를 치거나 중간에 끼어들면 목소리의 경계가 흐려집니다.
- 비슷한 음색: 성별이나 연령대가 비슷한 참석자들은 목소리의 음향학적 특징이 유사해 구분이 까다롭습니다.
- 주변 소음 및 원거리 수음: 회의실 중앙에 스마트폰 하나만 두고 녹음하면, 마이크에서 먼 참석자의 목소리는 특징을 추출하기 어렵습니다.
- 압축된 오디오 음원: 전화 통화 녹음이나 화상 회의 프로그램에서 압축된 음성은 음성 데이터의 세부 정보가 손실되어 분리 성능이 떨어집니다.
반대로 말하면, 녹음 품질이 좋을수록 화자 분리 정확도도 높아집니다. 참석자마다 개별 마이크를 사용하고, 조용한 공간에서 진행하며, 겹치지 않게 순서대로 발언하는 것만으로도 결과물이 눈에 띄게 개선됩니다. 또한, 대부분의 도구는 참석자 수를 사전에 지정하는 옵션을 제공하므로 정확한 인원수를 알고 있다면 수동으로 입력해 두는 것이 안전합니다.
세 가지 접근 방식: 클라우드 AI, 로컬 오픈소스, 전용 장비
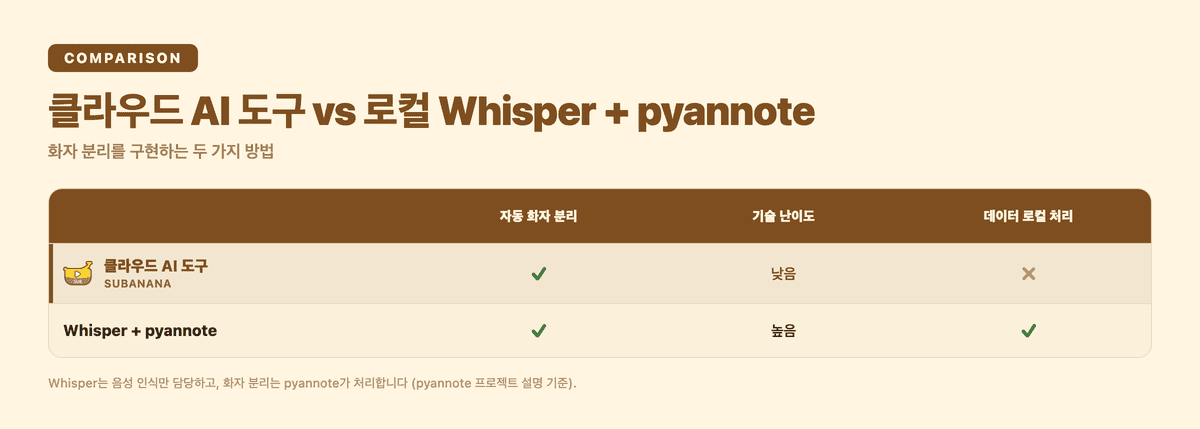
1. 클라우드 AI 음성 텍스트 변환 도구 (편리함, 자동화)
웹 브라우저에서 파일을 업로드하면 텍스트 변환과 화자 분리가 한 번에 자동으로 완료됩니다. 별도의 프로그램을 설치하거나 복잡한 설정을 할 필요가 없습니다. 대부분 문장 부호, 문단 나누기, 회의 요약까지 함께 처리해주므로 빠르게 실무용 회의록을 완성하고 싶은 분들에게 적합합니다. 다만 데이터를 클라우드 서버에 업로드해 처리해야 한다는 점을 고려해야 합니다.
2. 로컬 Whisper + pyannote 조합 (비용 0원, 높은 기술 난이도)
비용을 들이지 않고 구축하고 싶거나 사내 보안 규정상 오디오 데이터를 외부로 보낼 수 없다면, 개인 PC나 사내 서버에서 오픈소스 모델을 직접 구동할 수 있습니다.
여기서 주의할 점은 OpenAI의 Whisper는 음성 인식(STT)만 수행하며, 자체적인 화자 분리 기능은 제공하지 않는다는 사실입니다. 오픈소스 진영에서는 Whisper와 함께 pyannote-audio를 연동하는 방식을 표준처럼 활용합니다. pyannote 프로젝트 설명에 따르면 이 툴킷은 음성 활동 탐지(VAD), 화자 전환 탐지, 중첩 음성 감지, 화자 임베딩을 전문적으로 처리합니다. 즉, pyannote로 화자를 먼저 나눈 뒤 각 구간을 Whisper로 텍스트화하는 다단계 파이프라인을 구축해야 합니다.
- 추천 대상: Python 코드를 다룰 줄 알고, 환경 설정 및 GPU 인프라를 직접 관리할 수 있으며, 데이터의 로컬 처리가 필수인 사용자.
- 단점: 모델 다운로드, CUDA 환경 세팅, CLI 명령어 제어 등 기술적 진입 장벽이 높습니다.
3. 전용 녹음 하드웨어 도입
오프라인 회의가 잦은 팀이라면 다채널 마이크나 지향성 마이크가 탑재된 전용 회의 녹음기를 도입해 원본 오디오 품질을 높인 뒤 소프트웨어로 후처리하는 방법도 있습니다. 수음 품질을 근본적으로 개선할 수 있지만 초기 장비 구매 비용이 발생합니다.
Subanana로 화자별 회의록 만들기
Subanana는 첫 번째 방식에 해당하는 웹 기반 AI 도구로, 브라우저에서 손쉽게 화자가 분리된 회의록을 생성할 수 있습니다.
- 파일 업로드: 음성 또는 영상 파일(파일당 최대 30GB, 8시간 지원)을 업로드하거나, YouTube, Facebook, Instagram 등의 공개 링크를 붙여넣습니다.
- 언어 설정: 95개 이상의 언어 중 회의에서 쓰인 언어를 선택합니다. 여러 언어가 섞인 회의라면 유료 플랜의 Enhanced 변환에서 다국어 모드를 선택할 수 있습니다.
- 화자 수 지정: 자동 감지를 사용하거나, 실제 회의 참석자 수를 수동으로 지정할 수 있습니다.
- 결과 확인 및 편집: 변환이 끝나면 발언자별로 문단이 나뉘고 문장 부호가 정돈된 대화록이 생성됩니다. "참석자 1", "참석자 2"로 표기된 레이블을 실제 참석자 이름으로 변경해 완성도 높은 회의록으로 다듬을 수 있습니다.
- AI 회의 요약: 텍스트 변환본을 바탕으로 핵심 안건, 주요 결정 사항, 액션 아이템(Action Items)을 자동 생성할 수 있습니다. 회의·강연·의료·법률 등 30종 이상의 요약 템플릿 중에서 고를 수 있습니다.
변환 후 1~2분 정도 화자 레이블을 훑어보며 어긋난 부분을 수동으로 수정해 주면 결과물의 완성도를 크게 높일 수 있습니다. 무료 플랜에서도 업로드한 파일의 앞부분 15분 미리보기를 제공하므로, 짧은 회의 녹음본으로 화자 분리 성능을 먼저 테스트해 볼 수 있습니다. (DOCX, XLSX, TXT, Markdown, SRT, VTT 등의 파일 내보내기는 유료 플랜 기능입니다.) Subanana는 무제한 서비스가 아니라 플랜마다 매달 정해진 사용 시간(분)이 할당되는 방식으로, 화자 분리가 끝난 뒤 실제로 내려받아 쓸 수 있는 완성된 회의록 문서를 받는 데 초점이 맞춰져 있습니다.
Subanana가 맞지 않는 경우: 오디오 파일이 외부 네트워크나 클라우드로 단 한 번도 전송되어서는 안 되는 폐쇄망 보안 환경이라면, 로컬 환경에서 Whisper와 pyannote를 직접 구축하거나 사내 구축형(On-premise) 솔루션을 도입해야 합니다. 또한 단순히 오프라인 회의실의 울림이나 잡음이 심한 문제라면 툴을 바꾸기 전에 수음용 마이크 환경부터 개선하는 것이 효과적입니다.
자주 묻는 질문 (FAQ)
화자 분리(Speaker Diarization)란 무엇인가요? 녹음 파일에서 각 참석자의 목소리 음향 특징을 분석해 "누가, 언제" 발언했는지를 구분해내는 기술입니다. 음성을 문자로 바꾸는 음성 인식(STT)과 결합하여 화자별로 정돈된 대화록 및 회의록을 만들어 줍니다.
화자 분리 정확도를 높이려면 어떻게 해야 하나요? 가장 중요한 것은 원본 녹음의 품질입니다. 조용한 환경에서 녹음하고, 가급적 발언이 서로 겹치지 않도록 차례대로 이야기하며, 변환 시 참석자 수를 미리 지정해 주면 정확도가 크게 향상됩니다.
OpenAI의 Whisper 모델만으로 화자 구분이 가능한가요?
Whisper 자체는 음성을 텍스트로 바꾸는 STT 모델이며 화자 분리 기능은 포함되어 있지 않습니다. 로컬 환경에서 화자를 구분하려면 pyannote-audio 같은 전문 화자 분리 오픈소스 패키지를 Whisper 앞단에 연동해 구성해야 합니다. 이러한 복잡한 개발 설정 없이 바로 화자 분리된 회의록을 얻고자 한다면 화자 분리가 내장된 클라우드 도구를 사용하는 것이 간편합니다.
한국어 회의도 화자 분리가 잘 되나요? 네. 화자 분리는 언어가 아니라 목소리의 음향적 특징(음높이, 발음 습관, 억양 등)을 기준으로 동작하므로 한국어 회의에도 그대로 적용됩니다. Subanana는 한국어를 포함해 95개 이상의 언어로 음성을 텍스트로 변환하며, 여러 언어가 섞인 회의는 유료 플랜의 Enhanced 변환에서 다국어 모드로 처리할 수 있습니다.