여러 명이 참여하는 회의나 인터뷰 녹음을 텍스트로 변환하고 나면, "누가 어떤 말을 했는지" 구분이 안 되어 난감한 경우가 많습니다. 녹음본을 실질적으로 활용 가능한 회의록이나 인터뷰 녹취록으로 만들려면 '화자 분리(Speaker Diarization)' 기술이 필요합니다. 시스템이 목소리 고유의 특징을 분석해 '화자 1: …', '화자 2: …'와 같이 발화자별로 내용을 구분해 주는 방식입니다.
이 글에서는 화자 분리의 기본 원리와 인식이 어긋나는 주요 원인, 녹음 단계에서 정확도를 높이는 방법, 그리고 세 가지 해결 경로의 장단점을 정리해 드립니다. 본문 후반부에서 소개하는 Subanana는 제가 직접 운영하는 프로덕트로, 어떤 상황에 적합하고 어떤 경우에는 다른 도구를 선택해야 하는지도 가감 없이 솔직하게 다루겠습니다.
화자 분리와 음성 전사(STT)는 다른 작업입니다
- 음성 전사(STT, Speech-to-Text): 무엇을 말했는지 처리합니다. 즉, 오디오 음성을 텍스트로 변환하는 작업입니다.
- 화자 분리(Speaker Diarization): 누가 언제 말했는지를 처리합니다. 목소리 특징을 분석해 발화자가 바뀌는 구간을 감지하고, 각 음성 조각을 특정 화자에게 매칭합니다.
Google Cloud의 음성 인식 공식 문서를 살펴보면, 화자 분리는 일반 텍스트 변환 요청과 별개의 독립적인 파라미터로 작동한다고 설명합니다. 시스템이 화자의 전환 시점을 감지하고 번호로 각각의 음성을 식별하는 구조입니다. 즉, 텍스트 변환 위에 분석 레이어가 한 층 더 올라가는 셈이며, 두 단계가 모두 정확해야 '발화자별로 정돈된 녹취록'을 얻을 수 있습니다.
다자간 회의록, 인터뷰 녹취록, 여러 명이 출연하는 팟캐스트처럼 2명 이상이 참여한 녹음 파일은 화자 분리 적용 여부에 따라 결과물의 가독성과 실용성이 크게 달라집니다.
화자가 잘못 구분되는 경우
화자 분리 기술도 완벽할 수는 없으며, 다음과 같은 환경에서는 화자가 뒤바뀌거나 한 사람의 음성이 여러 명으로 나뉘어 인식되기 쉽습니다.
- 발언 겹침: 여러 사람이 동시에 맞장구를 치거나 말을 끊고 끼어들면 화자 간 경계가 모호해집니다.
- 비슷한 목소리: 동성 참석자이거나 연령대가 비슷해 음성 톤과 피치가 유사할 경우 구분이 까다로워집니다.
- 주변 소음 및 원거리 녹음: 스마트폰 한 대를 두고 회의실 전체를 녹음하면, 멀리 앉은 사람의 음성 품질이 저하되어 분리 성능이 떨어집니다.
- 압축 음원: 통화 녹음이나 온라인 화상 회의 오디오처럼 압축률이 높은 파일은 음성 특징 데이터 자체가 유실되어 판별이 어렵습니다.
반대로 말하면, 녹음 품질이 좋을수록 화자 분리 결과도 훨씬 정확해집니다. 참석자별 개별 마이크 사용, 조용한 환경 확보, 발언 순서를 정해 말하는 진행 방식만으로도 결과물이 눈에 띄게 개선됩니다. 아울러 대다수 도구에서는 화자 수를 미리 지정하는 기능을 지원하므로, 참석자 수가 명확하다면 자동 감지 대신 수동으로 입력하는 것이 훨씬 안정적입니다.
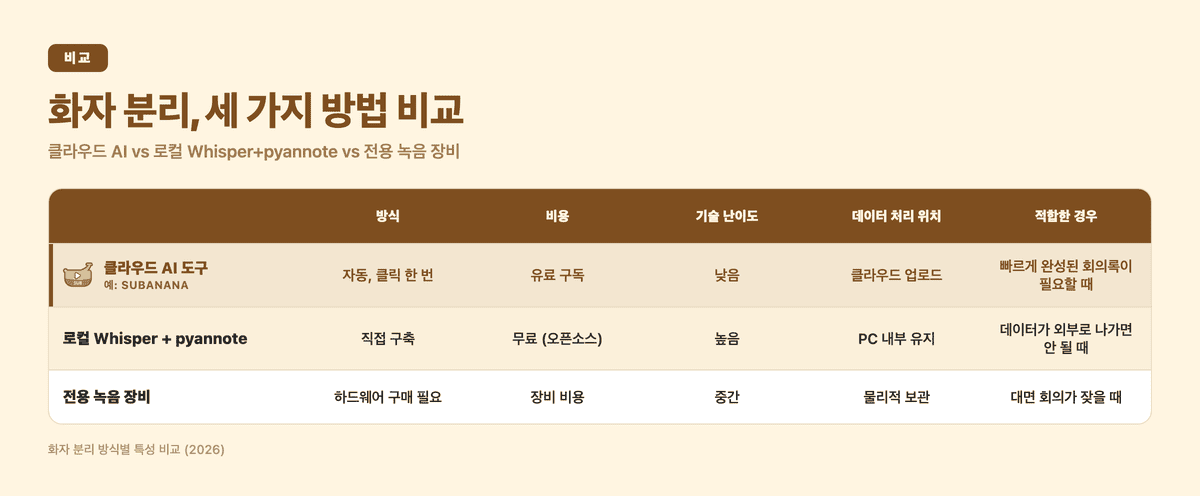
세 가지 방법: 클라우드 AI, 로컬 조합, 전용 장비
1. 클라우드 AI 음성 전사 도구 (편의성, 자동화)
웹 브라우저에서 파일을 업로드하면 텍스트 변환과 화자 분리가 한 번에 자동으로 처리되며, 별도의 프로그램 설치가 필요 없습니다. 대부분 구두점 추가, 문단 분리, 요약 기능까지 함께 제공되어 완성된 형태의 회의록을 바로 얻고자 할 때 적합합니다. 다만 오디오 파일이 클라우드로 업로드되어 처리된다는 점을 고려해야 합니다.
2. 로컬 Whisper + pyannote 조합 (무료, 높은 기술적 난이도)
비용을 들이지 않거나 보안상 데이터가 PC 외부로 나가면 안 되는 환경이라면 오픈소스 모델을 로컬 환경에서 직접 구동할 수 있습니다. 주의할 점은 OpenAI의 Whisper는 음성 전사(STT)만 담당하며 자체적인 화자 분리 기능은 지원하지 않는다는 사실입니다.
오픈소스 생태계에서는 주로 pyannote를 함께 연동합니다. pyannote-audio 프로젝트 저장소 설명을 확인해 보면, 음성 활동 감지(VAD), 화자 전환 감지, 발언 겹침 감지, 화자 임베딩(클러스터링)을 전담하는 오픈소스 툴킷임을 알 수 있습니다. 이 두 도구를 결합하여 '먼저 화자를 구분하고, 구간별로 텍스트를 변환'하는 파이프라인을 구축하게 됩니다.
- 장점: Python 개발 환경을 다룰 수 있고 로컬 보안을 엄격히 지켜야 하는 경우에 알맞습니다.
- 단점: 모델 다운로드, GPU 세팅, 커맨드라인 인터페이스 조작을 직접 해결해야 합니다.
3. 전용 회의 녹음 장비
오프라인 회의가 잦다면 다채널 마이크가 탑재된 전용 녹음 하드웨어로 고품질 오디오를 확보한 뒤 소프트웨어로 처리하는 방법입니다. 물리적 녹음 품질을 극대화할 수 있지만 별도의 장비 구매 비용이 발생합니다.
Subanana로 화자별 전사 만들기
Subanana는 첫 번째 방식(클라우드 기반 자동화)에 해당하며, 브라우저에서 몇 번의 클릭으로 화자 분리 녹취록을 생성할 수 있습니다.
- 파일 업로드 또는 링크 입력: 오디오/비디오 파일을 업로드(파일당 최대 30 GB 또는 8시간 지원)하거나, 공개된 YouTube, Instagram, Facebook 영상의 URL 링크를 바로 붙여넣습니다.
- 원본 언어 선택: 95개 이상의 다양한 언어 중에서 녹음의 원본 언어를 선택합니다.
- 화자 수 설정: 시스템 자동 감지를 이용하거나, 참석 인원수를 알고 있다면 수동으로 숫자를 지정합니다.
- 전사 및 화자별 결과 확인: 전사가 완료되면 화자별로 문단이 분리되고 문장 부호와 줄바꿈이 자동으로 적용됩니다. 웹 에디터에서 '화자 1', '화자 2' 라벨을 실제 참석자 이름으로 변경하면 완성도 높은 회의록이 됩니다.
- 회의 요약 생성 (선택 사항): 동일한 전사 텍스트를 바탕으로 30개 이상의 템플릿을 활용해 핵심 안건, 결정 사항, 실행 항목(Action Items)을 바로 생성할 수 있습니다.
전사 완료 후 1~2분 정도 화자 라벨을 훑어보며 가볍게 수정해 주면 문서 품질을 크게 끌어올릴 수 있습니다. 무료 플랜에서도 파일당 처음 15분 분량의 변환 결과를 미리 확인해 볼 수 있으므로, 짧은 회의 녹음본으로 화자 분리 성능을 먼저 테스트해 보시는 것을 권장합니다. 바로 웹에서 시험해 보고 싶다면 음성 텍스트 변환 도구 페이지를 이용하셔도 됩니다.
변환된 결과물은 결제 후 SRT, VTT, TXT, DOCX, XLSX, Markdown, FCPXML 등 7가지 포맷으로 내보낼 수 있으며, 세부 플랜은 요금제 안내 페이지에서 확인하실 수 있습니다.
Subanana가 적합하지 않은 경우: 보안 규정상 오디오 데이터를 외부 클라우드에 일절 전송할 수 없는 환경이라면 로컬 Whisper + pyannote 조합이나 자체 온프레미스(On-premise) 인프라를 구축하는 것이 맞습니다. 또한 현장 회의의 물리적인 마이크 수음 상태가 지나치게 열악하다면 녹음 장비와 환경을 먼저 개선하는 것이 더 실질적인 해결책입니다.
자주 묻는 질문 (FAQ)
화자 분리(Speaker Diarization)란 무엇인가요? 음성의 고유한 음향적 특성을 분석해 녹음 파일 속에서 "누가", "언제" 발언했는지를 식별하는 기술입니다. 음성을 문자로 바꾸는 텍스트 변환(STT)과 결합하여 화자별로 정돈된 회의록과 녹취록을 생성합니다.
화자 분리 정확도를 높이려면 어떻게 해야 하나요? 녹음 환경이 가장 중요합니다. 조용한 장소에서 가능한 한 참석자별 개별 마이크를 사용하고, 발언이 겹치지 않도록 조율해 주세요. 변환 전 도구 설정에서 화자 수를 수동으로 지정하고, 변환 후 이름 라벨을 한 번 검토해 수정하면 훨씬 깔끔한 문서를 얻을 수 있습니다.
Whisper 모델만으로 화자 분리가 가능한가요? 불가능합니다. OpenAI의 Whisper는 음성을 텍스트로 바꾸는 STT 모델이며 자체적인 화자 분리 기능은 포함되어 있지 않습니다. 로컬 환경에서 구축하려면 pyannote와 같은 전용 분리 라이브러리를 연동해야 합니다. 복잡한 환경 설정이 번거롭다면 화자 분리가 기본 내장된 클라우드 도구를 사용하는 것이 효율적입니다.
다양한 언어의 음성에서도 화자 분리가 잘 작동하나요? 네, 잘 작동합니다. 화자 분리는 언어의 의미가 아니라 목소리의 음색, 피치, 주파수 패턴 등 물리적 특성을 기반으로 화자를 식별하기 때문에 언어 종류에 구애받지 않고 동작합니다.