
In juli 2025 duurde het verwerken van een opname van een vergadering van één uur 26.8 minuten.
Deze maand kost dezelfde klus 4.9 minuten.
Dit is geen benchmark die mooi moest ogen. Het is de mediaan van onze verwerkingstijden voor vergaderingen van één uur in elk van die twee juli-maanden — geen zorgvuldig gekozen demobestand — en mislukte klussen zijn aan beide kanten weggelaten. Zelfde maand van het jaar, zelfde bestandslengtes, zelfde meetmethode. Ongeveer vijfenhalf keer zo snel — en lange bestanden gingen er nog meer op vooruit.
Niemand heeft een "alles sneller"-release uitgebracht. Dit is een jaar onopvallend werk aan de delen van de pipeline waar niemand blogposts over schrijft, en het stapelde zich op.
Wat er werkelijk veranderde
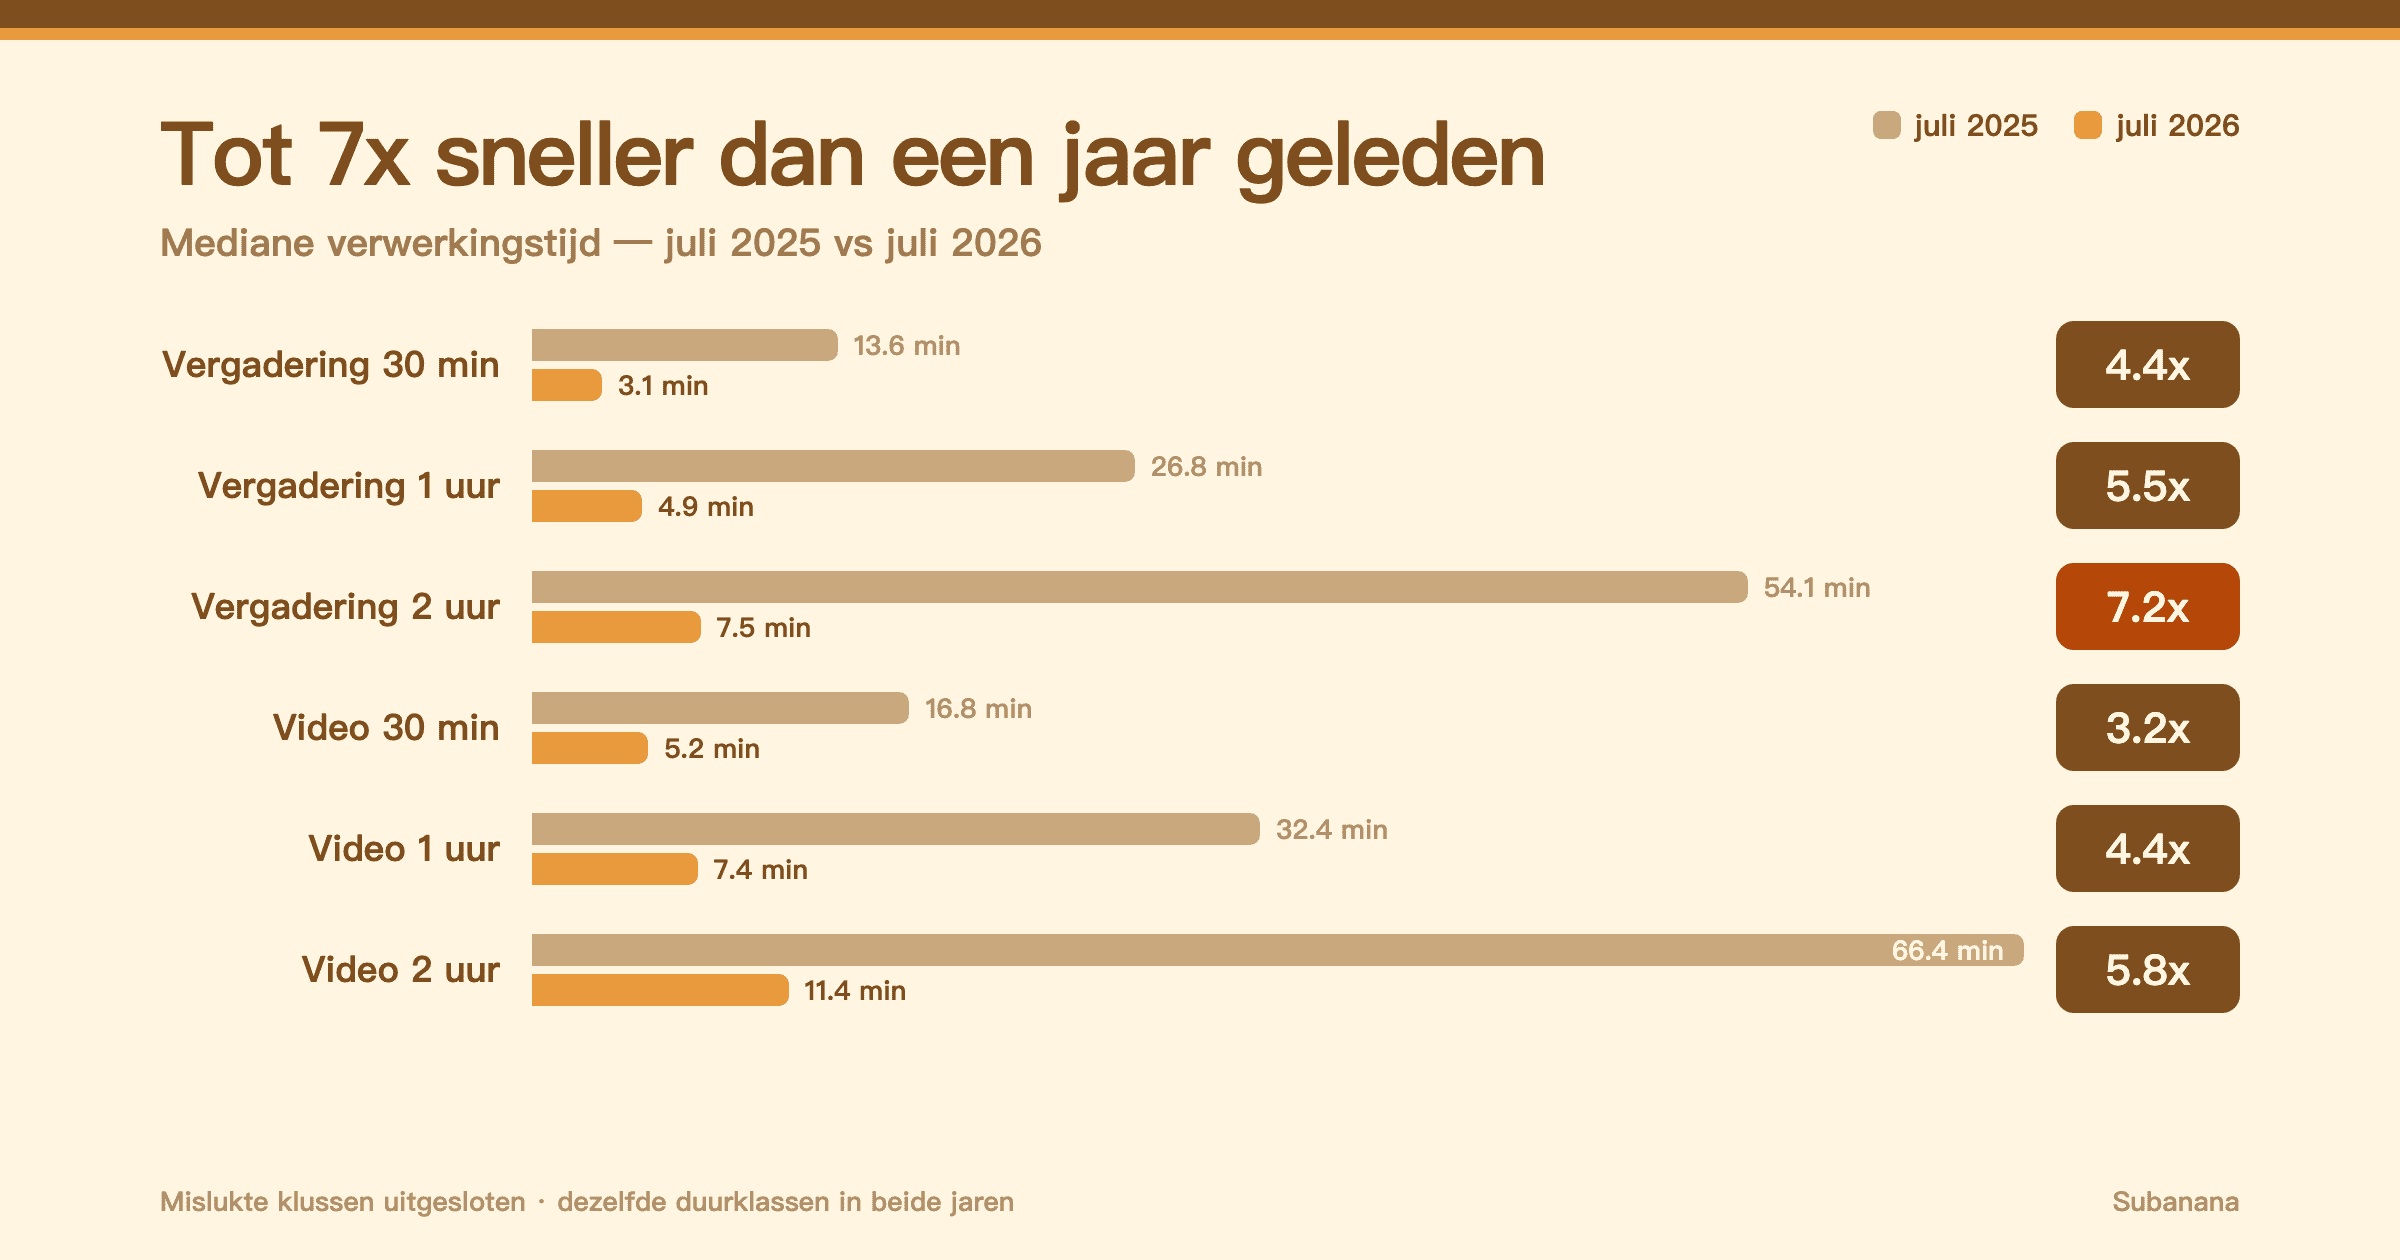
Mediaan van de verwerkingstijd, juli 2025 tegenover juli 2026. Het tweede getal in elke cel is het traagste tiende deel — de één op tien klussen die het langst duurt. Medianen flatteren; de staarten laten zien hoe een slechte dag eruitziet.
| Klus | Juli 2025 | Juli 2026 | Sneller |
|---|---|---|---|
| Vergadering 30 min | 13.6 min (p90 26.4) | 3.1 min (p90 5.9) | 4.4x |
| Vergadering 1 uur | 26.8 min (p90 61.9) | 4.9 min (p90 6.8) | 5.5x |
| Vergadering 2 uur | 54.1 min (p90 120.9) | 7.5 min (p90 13.4) | 7.2x |
| Video 30 min | 16.8 min (p90 35.6) | 5.2 min (p90 12.1) | 3.2x |
| Video 1 uur | 32.4 min (p90 136.4) | 7.4 min (p90 21.0) | 4.4x |
| Video 2 uur | 66.4 min (p90 147.3) | 11.4 min (p90 28.9) | 5.8x |
De staarten verbeterden nog sterker dan de mediaan, en dat telt zwaarder. Een jaar geleden had één op de tien vergaderingen van een uur meer dan een uur nodig. Nu begint het traagste tiende deel bij zeven minuten — een slechte klus van vandaag is meerdere keren sneller dan een doorsnee klus van toen. Het slechtste geval bij een video van één uur ging van ruim twee uur naar 21 minuten. Als je stiekem marge inbouwde in je agenda vanwege Subanana, kun je daarmee stoppen.
Lange bestanden wonnen het meest — de 7x staat op de regel "Vergadering 2 uur". Dat is het omgekeerde van wat er meestal gebeurt als een pipeline wordt afgesteld op korte democlips, en juist dat verschil verandert gedrag: anderhalf uur wachten is een klus voor "na de lunch terugkomen"; zeven minuten is een klus voor "blijven zitten".
En de trend vlakt niet af: de laatste week van juli was de snelste week uit de geschiedenis van Subanana, met een mediaan van 5.5 minuten voor video's van één uur.
Het deel dat me verraste
Zo is de wachttijd van een video van één uur vandaag verdeeld. De fasen overlappen elkaar — lees ze als ruwe verhoudingen, niet als een strikte volgorde.
| Fase | Aandeel in de wachttijd |
|---|---|
| Wachten in de wachtrij | ~7% |
| Bestand de pipeline in krijgen | ~2% |
| Media voorbereiden (audio, golfvorm) | ~25% |
| Transcriberen | ~20% |
| Ondertitels opbouwen en controleren | ~16% |
| Preview renderen waar je daarna doorheen scrubt | ~29% |
Transcriberen — het AI-deel — is ongeveer een vijfde van de wachttijd.
De AI was nooit de bottleneck. Iedereen denkt dat spraakherkenning het trage deel is, omdat dat het deel met het model is. Dat is niet zo, en al een hele tijd niet. Ruwweg vier vijfde van je wachttijd is logistiek: het bestand decoderen, een schone audiotrack eruit halen, de golfvorm genereren, de preview renderen die de editor nodig heeft zodat je het resultaat daarna kunt doorlopen.
Precies daarom kwamen de winsten waar ze vandaan kwamen. Alleen al het binnenbrengen van je bestand is sinds juni ruim 90% sneller geworden, en de mediavoorbereiding is ongeveer gehalveerd. Op het transcriberen viel weinig te winnen. Op al het andere heel veel.
Uit die tabel volgen drie dingen die handig zijn om te weten:
Vergaderingen komen het snelst terug. Een vergaderklus slaat het renderen van de videopreview volledig over — een groot deel van de verklaring waarom de vergaderregels bij gelijke lengte altijd vóór de videoregels liggen.
Een vertaling toevoegen vertraagt je resultaat niet. Vertalingen draaien asynchroon — het transcript en de ondertitels in de oorspronkelijke taal komen even snel binnen als anders, en de vertaalde track volgt vanzelf. Liet je het vertaaldoel weg om tijd te sparen? Niet nodig. In ondertitelmodus kun je één klus meerdere doeltalen geven.
Je upload zit niet in deze cijfers. De klok start zodra de verwerking begint, nadat je bestand is aangekomen. Op een trage verbinding kan de upload de langste helft van je wachttijd zijn. Is de video toch al openbaar, plak dan een YouTube-, Instagram- of Facebook-link en sla de upload over — Subanana haalt hem rechtstreeks op.
Het deel waar geen sluiproute voor bestaat
Een goed spraakherkenningsmodel kan iedereen huren. Dat is het publieke geheim van deze categorie — de AI, het deel met de mystiek, is beschikbaar voor iedereen die een API-sleutel aanvraagt. Daarom verschijnt er elke week een nieuwe transcriptie-app.
Maar het model is een vijfde van je wachttijd. De andere vier vijfde is de machinerie eromheen: invoer, decoderen, audio-extractie, ondertitels opbouwen, previews renderen, wachtrijen. Niets daarvan is te huur. Het moet gebouwd worden, gemeten op echte werklast, en opnieuw gebouwd — en de enige manier waarop het sneller wordt, is engineeringtijd steken in problemen die in geen enkele demo ooit opduiken.
Dat is wat dit jaar werkelijk was. Geen grote release en geen gelukkige modelwissel: de versnelling stapelde zich de afgelopen anderhalf jaar bijna elke maand verder op. Een in een weekend in elkaar gezette wrapper-app kan dezelfde transcriptie gebruiken als wij. De vier vijfde kan hij niet namaken — en dat is precies wat je voelt bij elke lange upload.
Wat er niet verandert
Nieuwe pogingen blijven gratis. Ziet een transcript er niet goed uit, dan stuurt het systeem de betreffende segmenten op de achtergrond automatisch door een ander model — zonder melding. De tweede ronde kost niets: je betaalt één keer per bestand, hoeveel interne pogingen er ook nodig waren. Dat gold een jaar geleden en dat geldt nu; het gaat alleen sneller.
De limieten zijn ook niet veranderd: 3 uur en 15 GB per bestand in het betaalde abonnement. In de praktijk loop je het eerst tegen het plafond van 3 uur aan.
Probeer het met iets langs
Als je een opname van twee uur bleef uitstellen omdat je er geen uur aan wilde verliezen: die rekensom is veranderd. Het is nu ongeveer elf minuten.
AI-vergadertranscriptie en AI-ondertiteling draaien allebei op de pipeline waar deze cijfers vandaan komen.
Alle cijfers zijn medianen van de verwerkingstijd — juli 2025 (volledige maand) tegenover 1–27 juli 2026 — gegroepeerd op bronlengte, mislukte klussen uitgesloten, gemeten vanaf de start van de verwerking. De "2 uur"-regels beslaan bestanden van 90 minuten tot 3 uur. Je tijden variëren met bestandsgrootte, codec en belasting.