
把一段錄音變成逐字稿,實際上是五個動作:把音檔上傳、讓語音辨識跑一次、把講者分開、對著時間軸校對,再匯出成你要的檔案格式。現在的逐字稿產生器已經把前面幾步做掉大半,真正花時間的是第四步。
這篇文章寫的是完整流程。哪些音檔格式可以直接上傳、檔案多長會超過上限、講者人數要不要自己填、校對的時候 AI 幫得到什麼又幫不到什麼、六種匯出格式各自適合什麼用途,以及免費方案實際上能做到哪一步。
文中的產品規格以 Subanana 為例,因為那是我們自己的工具,數字可以講到具體。語音轉逐字稿的流程本身在多數 AI 工具上是共通的。

逐字稿是什麼?和會議紀錄、字幕檔差在哪?
逐字稿是把錄音內容完整轉成文字的稿件:每一句都保留,包含重複、口頭禪和停頓,通常還帶著講者標記與時間資訊。它和會議紀錄、字幕檔經常被混在一起講,但三者的產出目標並不相同。
| 逐字稿 | 會議紀錄 | 字幕檔 | |
|---|---|---|---|
| 內容完整度 | 全文照錄 | 只留決議與待辦 | 依畫面切成短句 |
| 保留口語與重複 | 視用途取捨 | 不保留 | 不保留 |
| 時間軸 | 可有可無 | 沒有 | 必須有 |
| 常見格式 | DOCX、TXT、XLSX | DOCX、Markdown | SRT、VTT |
| 典型用途 | 訪談引用、研究編碼、法務存證 | 會後追蹤 | 影片上字幕 |
判斷的原則很單純。要引用原話、要證據、要做編碼分析,就做逐字稿;只需要知道結論和誰負責什麼,做會議紀錄;文字最後會壓在影片上,做字幕檔。
順序上這三者是可以疊起來的:先有逐字稿,才有辦法生成準確的會議紀錄,也才切得出對得上畫面的字幕。反過來從一份摘要回推逐字稿是做不到的,資訊已經在摘要那一步被丟掉了。
「完整」也不代表原封不動。逐字稿模式產出的稿件會自動去掉贅詞、補回標點並重新分段,這件事沒有開關,是固定開著的。字幕模式則相反,依照字幕的慣例不加標點。所以同一段錄音走哪一個模式,拿到的文字長相不一樣,選錯了會多花一輪整理的時間。
怎麼把錄音檔轉成逐字稿?五個步驟走完整個流程
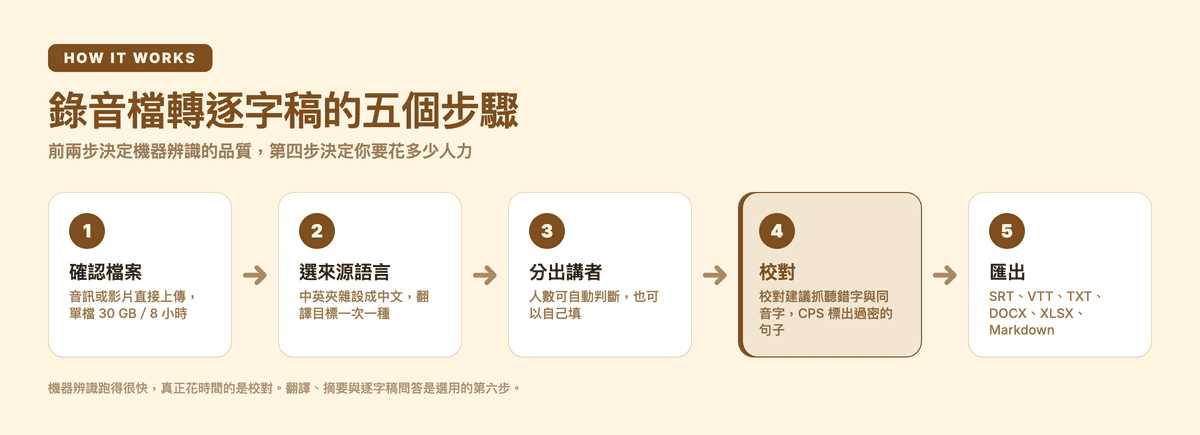
下面五個步驟是把一個錄音檔變成可以交出去的稿件的實際順序,第六步則看你需不需要。第一步和第二步決定機器辨識的品質,第四步決定你要投入多少人力。
一、先確認音檔格式和長度
可以直接上傳的音訊格式包括 .mp3、.m4a、.wav、.ogg、.aac、.flac、.opus。如果來源是影片,.mp4、.mov、.m4v、.webm、.mkv、.mpeg 也能直接丟進去,不需要自己先抽出音軌。手機錄音、會議軟體錄下來的檔案、錄音筆匯出的檔案,多半就落在這幾種副檔名裡面。
單一檔案的上限是 30 GB 或 8 小時,所有方案都一樣,不分免費或付費。超過就分段:一場全天的研討會本來多半就會按場次分開錄,兩三個小時一段反而好管理,回頭校對時也比較好定位。
如果錄音已經放在公開的 YouTube、Instagram 或 Facebook 上,可以直接貼網址讓系統去抓,不必先下載再上傳,Shorts 和 Reels 同樣適用。這條路徑涵蓋的是公開內容,需要登入才看得到的影片還是自己下載後上傳比較保險。
各種來源之間的差別,例如 iPhone 內建錄音、線上網頁工具與 AI 平台,整理在錄音檔轉文字的工具比較。
二、選對來源語言
來源語言選錯,後面全部白做。系統是按照你指定的語言去挑辨識模型的,把國語錄音標成英文,出來的會是一串讀音相近的英文單字,而不是一份可以校對的中文稿。
台灣的錄音常見的狀況是中英夾雜:講中文,但專有名詞、產品名和職稱講英文。這種情況把來源語言設成中文就好,句子裡的英文詞會照原樣留著;不要為了少數幾個英文詞把整份稿子設成英文。
Subanana 的來源語言涵蓋 95+ 種語言。需要翻譯的話,翻譯的目標語言一次只能設定一個,要兩種語言就跑兩次。
三、分出講者
講者人數可以讓系統自動判斷,也可以自己填。訪談和焦點團體建議自己填,因為你事前就知道有幾個人。講者分離靠的是聲音特徵,兩個人音色接近或經常同時說話的時候最容易分錯,先給定人數等於少讓系統猜一件事。
錄音當下有一個習慣可以省下大量校對時間:開場讓每個人自報姓名,之後盡量不要互相蓋話。這樣稿子裡的「講者 1」「講者 2」你一眼就對得上是誰,標籤改一次就到底。
訪談情境的完整做法,包含逐字或清稿的取捨與引用格式,寫在訪談逐字稿的做法;焦點團體與論文訪談另外整理在質性研究逐字稿與編碼準備。
四、對著時間軸校對
這是整個流程裡最花人力的一步,也是各家工具差距最明顯的地方。
轉出來的文字在編輯器裡會帶兩類提示。一類是 LLM 校對建議,它找的是聽錯的字和同音字,例如把「在見」標出來、建議改成「再見」,由你按接受或忽略,它不會自己動手改。範圍就到這裡為止:漏掉的字它補不回來,因為它只看得到稿子上有的字,看不到音檔裡少了什麼;時間軸和斷句它也不碰。
另一類是 CPS 標示,也就是每秒字數。它是一條固定規則,把太密或太稀疏的句子標出來,判斷的是這一句在這個秒數裡讀不讀得完。它跟機器學習無關,也不是模型信心度。
真正能減少校對量的動作要在轉檔之前做:把人名、公司名、產品名和專業術語先放進詞彙表。詞彙表分成工作區層級(每個專案都套用)和自訂清單(只掛在特定專案上),可以一個一個加、整批貼上,也可以用 XLSX 或 CSV 匯入,每個詞還能標成通用或限定某個語言。話講在前面:使用者自訂詞彙表是這類工具的標準配備,多數同類產品都有,差別在分層和批次匯入的細緻程度,不在有沒有這項功能。
另一個方向是背景資料包,把簡報、PDF、會議議程或一段網址丟進去當參考,讓系統先知道這場在談什麼。
五、匯出成你要的格式
匯出有六種獨立格式,也可以打包成一個 ZIP 一次拿走全部。
| 格式 | 適合用途 |
|---|---|
| SRT | 影片上字幕,最通用 |
| VTT | 網頁播放器字幕 |
| TXT | 純文字,貼進其他工具再加工 |
| DOCX | 交稿、排版、加批註 |
| XLSX | 逐句一列並帶時間軸,適合研究編碼與引用查找 |
| Markdown | 貼進筆記或文件工具 |
清單上沒有 PDF。需要 PDF 的話先匯出 DOCX,再用文書軟體另存。
實務上最常用的組合是 DOCX 加 XLSX:DOCX 拿去交稿或排版,XLSX 用來回頭找某一句話出現在第幾分幾秒。
六、(選用)翻譯、摘要與問答
翻譯的目標語言一次一個。摘要有 30 種以上的內建範本,涵蓋會議、演講、商務、醫療、法律與創作者等情境,也可以自己建一個。稿子生出來之後還能直接在編輯器裡問 AI 問題,例如「我們對報價的決議是什麼」,答案是根據這份逐字稿回答的,不必自己滑上去找。
如果你要的其實是會議結論而不是全文,會議紀錄格式與範本整理了常見格式與寫法。
想照著上面的順序實際跑一次,可以先拿自己的錄音檔試一段:
立即免費試用 Subanana為什麼錄音品質決定校對時間?
會議室裡一支麥克風收五個人,離麥克風最遠的那一位講的話錯字最多,而那常常就是你最需要引用的那一段。可以的話把麥克風放在主要發言者附近,或者每人各錄一軌之後分開上傳。
線上會議不要用手機在旁邊錄喇叭放出來的聲音。直接開會議軟體本身的錄影功能,錄到的是每個人的音訊直接進來,沒有經過空氣和喇叭這一層。
冷氣、投影機風扇、咖啡廳的背景音樂這類持續性噪音,比偶爾一次的關門聲更麻煩,因為它整段都在。錄之前把冷氣調小或換一間房間,比事後逐句聽回去便宜得多。
開場請每個人自報姓名,一句就好。這一句讓講者標籤從頭到尾都對得上。
事前把這場會用得到的專有名詞放進詞彙表。同一個公司名如果被辨識成三種寫法,你要在稿子裡改三十次;先設定好就只需要處理一次。
錄音會超過八小時或檔案會超過 30 GB 的話,錄的時候就分段,不要等上傳被擋下來才回頭切。
免費工具能做到哪裡?
這一節講的是界線,因為多數「免費逐字稿」的搜尋結果不會把它講清楚。
Subanana 的免費方案可以讓你看到結果,但拿不走檔案。具體是這樣:
- 每個檔案生成並預覽前 15 分鐘。
- 每個月 3 次上傳。
- 每個檔案一樣可以到 30 GB、8 小時,這一項和付費方案完全相同。
- 無法匯出逐字稿或字幕,SRT、VTT、TXT、DOCX 都不行;在編輯器裡選取複製逐字稿文字也不行。
- 唯一能輸出的東西是帶浮水印的影片,前 5 分鐘、最高 720p。
付費方案移除浮水印,解鎖那六種格式的匯出與文字複製。
所以免費方案的正確用法是驗證:拿一段你手上最難處理的錄音,口音重的、中英夾雜的、多人同時說話的那一段,上傳之後看前 15 分鐘轉出來的品質,再決定值不值得付費。想用它完成一份要交出去的稿件是行不通的,界線就畫在「把檔案帶走」這個動作上。
外包聽打和 AI 工具在同樣一小時錄音上的實際花費與時間差距,整理在台灣逐字稿工具的費用與時間比較。
立即免費試用 Subanana常見問題
一小時的錄音要多久才轉得好?
機器辨識那一段跑得很快,時間主要花在校對。錄音清楚、講者人數少,改起來很快;多人、口音重、專業術語密集的錄音會慢上好幾倍。校對時間的差距來自錄音品質,不是來自工具。
mp3 可以直接上傳嗎?
可以,不需要先轉檔。.mp3、.m4a、.wav、.ogg、.aac、.flac、.opus 都能直接上傳,.mp4、.mov 這類影片檔也可以,系統會自己處理音軌。
逐字稿和會議紀錄該選哪一個?
要引用原話、要證據、之後要做分析就選逐字稿;只需要知道決議和待辦就選會議紀錄。兩者不衝突,先有逐字稿再生成會議紀錄是最省事的順序。
可以分出誰在講話嗎?
可以。講者人數能自動判斷,也能自己填。已知人數的訪談建議自己填,並且在錄音開場請每個人自報姓名。
可以匯出 PDF 嗎?
不行。獨立的匯出格式有六種:SRT、VTT、TXT、DOCX、XLSX、Markdown,另外可以打包成 ZIP 一次下載。需要 PDF 的話先匯出 DOCX 再另存。
免費方案可以下載逐字稿嗎?
不行。免費方案能生成並預覽每個檔案的前 15 分鐘,但沒有逐字稿與字幕的匯出,也不能在編輯器裡複製文字,唯一的輸出是帶浮水印的影片。匯出就是付費的界線。
中英夾雜的錄音怎麼設定?
來源語言設成中文即可,句子裡的英文詞會照原樣保留。把會出現的英文專有名詞先放進詞彙表,寫法才會前後一致。
語音辨識到底準不準?
這件事沒有單一答案,取決於錄音品質和語言。Subanana 的做法是持續評測多個語音辨識模型,依照來源語言和用途(字幕或逐字稿)挑當下表現最好的那一個,不綁定單一供應商。每份輸出都會做品質檢查,發現有問題的片段,尤其是產生了音檔裡根本沒有的內容,會自動改由另一個評測過的模型重跑。剩下的部分靠編輯器裡的校對建議和 CPS 標示收尾。運作原理的細節寫在AI 逐字稿的運作原理。