
質的研究における逐語録は、分析の一次データ(raw data)そのものです。卒論や修論、博論の執筆をはじめ、看護、教育、心理、社会学などのインタビュー調査では、研究協力者の発言をいかに正確かつ分析しやすい形で文字化できるかが研究の質を左右します。
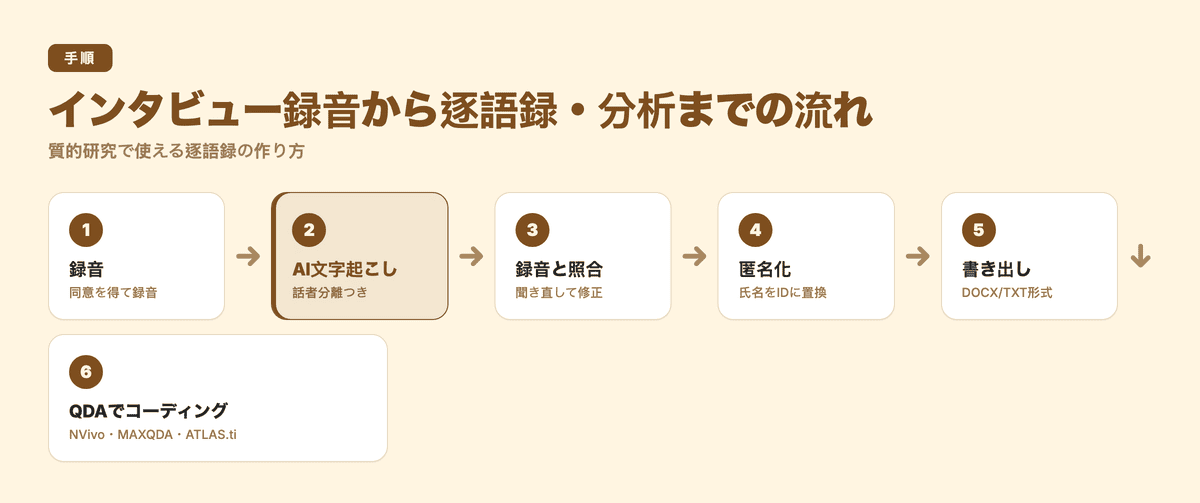
作成の基本的な流れは、「録音 → AIで話者付きの文字起こし → 録音を聞きながら人の目で確認(固有名詞・専門用語・引用部分) → 研究協力者をIDに置き換えて匿名化 → DOCX/TXTで書き出し → QDAソフトでコーディング」という6つのステップです。
この記事では、論文にそのまま引用でき、質的データ分析ソフト(QDAソフト)でのコーディングにもスムーズに移行できる逐語録の作成手順を詳しく解説します。
質的研究の逐語録は普通の文字起こしと何が違う?
一般的な文字起こしは内容の大枠を把握できれば十分なことも多いですが、質的研究の逐語録には研究データとしての厳密さが求められます。
- 誰の発言かを正確に追える:研究者と研究協力者の区別はもちろん、フォーカスグループインタビューでは参加者ごとの発言を識別できなければ、個人ごとの文脈や発言の比較ができません。
- 論文にそのまま引用できる:論文本文に引用する発話は、決めた表記ルールの範囲で、録音と語句・意味が一致していることが求められます。
- QDAソフトに読み込める構造になっている:NVivoやMAXQDAなどのソフトでスムーズにセグメント化できるよう、発言者ラベルと段落が整理されている必要があります。
- 適切に匿名化されている:研究倫理の観点から、個人が特定される情報を伏せつつ、分析の文脈を損なわない表記が求められます。
文字起こしツールを使う際、短く区切られて句読点のない字幕用SRTファイルなどは逐語録に向きません。必ず文章として段落や句読点が整う文字起こし用のモードを選択してください。
なお、インタビュー調査全体の設計や質問項目の組み立て方については、半構造化インタビューの作り方で詳しく解説しています。
逐語録をどこまで「逐語」にするか
文字起こしを行う前に、どこまで厳密に発話を残すかという表記ルールを決めておく必要があります。
会話分析など発話の相互行為そのものを詳細に検討する研究では、言い直しや間(ポーズ)、相槌、「えー」「あのー」といったフィラーも重要なデータとなるため、すべて残す「素起こし」に加え、間の長さや発話の重なりを記号で書き表す専用の転記法が用いられます。一方で、テーマ分析や内容分析のように語られた内容に注目する分析では、文脈を損なわない範囲でフィラーを除いた「ケバ取り」程度で足りることが多いでしょう。ただし、研究協力者が使った言葉の意味を変えてしまうような整文(リライト)は避けてください。
詳しい書き分けの基準は、素起こし・ケバ取り・整文の違いを参考にしてください。事前に決めた表記ルールは、論文の「方法」セクションに明記します。
表記ルールの例:
- 聞き取り不能な箇所:[聞き取り不能][判別できず]
- 非言語的な情報:(笑い)(沈黙 約3秒)
- プライバシー情報:[勤務先A病院][地域名X県]
インタビュー調査の文字起こし:3つの方法
インタビュー調査の文字起こしには、主に3つのアプローチがあります。研究の規模やかけられる労力に応じて選択します。
| 方法 | かかる手間 | 話者の区別 | 向いているケース |
|---|---|---|---|
| 自分で手作業 | 非常に大きい | 録音を聞きながら自分で入力 | 発話を極めて細かく分析する少数のケース |
| 文字起こし外注 | 小さい(やりとりのみ) | 指示内容に応じて作業者が対応 | 予算があり、守秘義務契約が結べる場合 |
| AI文字起こし+自分で確認 | 中程度 | ツールによる話者分離を活用 | 多くの論文インタビュー、フォーカスグループ |
AI文字起こしを活用することで、キーボードを叩いて文章を一から入力する負担は大幅に軽減されます。しかし、最終確認は必ず人間が録音を聞きながら行わなければなりません。特に論文で鍵となる引用箇所ほど、発話の細部まで丁寧に聞き直して確認することが不可欠です。一般的なインタビューの書き起こし全般については、インタビューの文字起こし方法でも触れています。
フォーカスグループインタビューの逐語録で話者を分けるには
複数人が参加するフォーカスグループインタビューでは、誰がどの発言をしたかを区別する話者分離(ダイアライゼーション)が最大の課題になります。話者が混ざってしまうと、特定の発言に対するリアクションなのか、誰がどのような意見の変遷をたどったのかが追えなくなります。詳しい仕組みについては、話者分離できる文字起こしとはで解説しています。
参加人数が分かっているときは、AI文字起こしの前に、司会者を含めた話者数を指定しておきます。文字起こし後は、各発言者ラベルを研究協力者のID(P1、参加者Aなど)に置き換えていきます。
話者をきれいに分けるには、録音時の工夫も大切です。
- 卓上の中央に無指向性マイクを設置する
- 発言前に、事前に割り当てた番号や仮名を名乗ってもらうルールにする(本名は名乗らない)
- 発言が重なった際は司会者(モデレーター)が整理し、一人ずつ話してもらう
ただし、複数人の声が完全に重なってしまった箇所や、極端に小さな声の発話は、AI任せにせず人間の耳で確認して補正する必要があります。
匿名化と保存で気をつけること
質的研究では、研究協力者のプライバシー保護が極めて重要です。逐語録を作成する段階から、以下のルールを徹底しましょう。
- 録音の同意と外部サービスの利用:録音とその利用方法について、事前に研究協力者からインフォームド・コンセントを得ます。AI文字起こしサービスに録音をアップロードすると、データを外部のクラウドに預けることになります。研究計画書や同意説明文書に書いた保存場所・外部委託の扱いと食い違わないか、利用前に確認してください(Subananaのデータは AWS シンガポールのリージョンに保存されます)。
- 研究協力者はIDで表記する:本名ではなく「A氏」「協力者1」「P1」などの記号に置き換えます。
- 固有名詞のマスキング:具体的な病院名、学校名、企業名、特徴的な地名などは、「[B大学病院]」「[地方都市C]」のように上位カテゴリーや記号に置き換えます。
- 対応表の厳重管理:誰がどのIDに対応しているかを示す「対応表」は、逐語録のテキストファイルとは完全に切り離し、パスワードをかけた安全な場所に保管します。
- データの取り扱い:録音データや文字起こしテキストの保存期間や破棄方法については、所属機関のルールや倫理審査で承認された研究計画に沿って適切に扱ってください。
日本語の逐語録で確認したいポイント
AIによる自動文字起こしを活用する場合でも、日本語特有の誤りが発生しやすいため、以下のポイントを録音と照らし合わせて確認しましょう。実際の録音データから数分間をテストして、どのような誤りが出やすいか事前に把握しておくことをおすすめします。
固有名詞・専門用語
医療用語、教育現場の専門用語、研究領域の学術用語は、一般的な言葉に置き換わってしまうことがあります。重要なキーワードは一括検索して確認します。
同音異義語
「関心/感心/歓心」「意思/意志」「保証/保障/補償」など、文脈によって漢字の使い分けが必要な語句は人の目で文脈を判断します。
句読点と文の区切り
日本語の話し言葉は文末が曖昧になりがちです。どこで文が切れているかによって意味の解釈が変わることがあるため、発話のニュアンスに沿った適切な位置に句読点が置かれているかを確認します。
話者の取り違え
声質が似ている参加者同士の会話や、相槌が連続する場面では、発話者の境界がずれることがあります。重要な主張をしている発言者は特に注意深くチェックします。
聞き取れない箇所の表記
AIが無理に言葉を当てはめてしまっているケースがあります。音声を聞いて判別できない箇所は、推測で埋めずに[聞き取り不能]などの統一ルールに従って処理します。
Subananaでインタビュー録音から逐語録を作る手順
話者付きの逐語録をファイルで書き出したい場合は、話者分離・編集・エクスポートが1つのツールでそろっていると作業が途切れません。ここではブラウザで使えるAI文字起こしツールSubananaを使った手順を紹介します(インタビューの文字起こしツール)。
- 録音ファイルをアップロードする
ブラウザから音声・動画ファイル(mp3, m4a, wav, mp4, movなど)をアップロードします(各プラン最大8時間/30GBまで対応)。 - 文字起こしモードを選択する
字幕用ではなく、文章としてまとまる文字起こし用のモードを選びます。句読点と段落は自動で付きます。 - 言語と話者数を指定する
元の言語(日本語など95以上の言語に対応)を選び、インタビュアー(司会者)を含めた話者の人数を設定します。自動判定にすることも可能です。 - 必要に応じて逐語設定を調整する
Subananaは標準で「えー」「あのー」などのフィラーを除去した読みやすい状態(ケバ取りに近い形)に整えます。会話分析などでフィラーをそのまま残したい場合は、単一ファイルアップロード時に発話をそのまま残す設定を利用できます。ただし、間の秒数や発話の重なりなど、会話分析で使う転記記号(ジェファーソン式など)は自動では付かないため、録音を聞きながら手作業で書き加えます。 - エディタで確認と編集を行う
AI校正機能が、聞き間違いや同音異義語、誤字、句読点などについて修正案を出すので、内容を確認しながら採用するか判断します。ただし、抜け落ちた言葉を補う機能ではないため、引用箇所は録音と照合します。自動で付いた話者ラベルは、A氏やP1などのIDに変更します。逐語録内の特定トピックを検索したいときは、エディタ内のAIチャットで該当箇所を探すことも可能です。 - DOCXまたはTXT形式で書き出す
仕上がった逐語録をファイルとしてエクスポートします。QDAソフトに読み込むならDOCXかTXTが扱いやすい形式です。
無料プランでは月に3回までのアップロードが可能で、各ファイル15分までの画面上プレビューに対応しています(ファイルの書き出しやテキストのコピーには有料プランが必要です)。
逐語録をNVivo・MAXQDA・ATLAS.tiに読み込んでコーディングする
完成した逐語録は、質的データ分析ソフト(QDAソフト / CAQDAS)にインポートしてコーディングを進めます。各ソフトのインポート仕様に合わせた形式で書き出しておくと、その後の作業が非常にスムーズになります。
- NVivoのファイル取り込み:Word形式(.docx)やプレーンテキスト(.txt)などの文書ファイルを直接取り込めます。
- MAXQDAの文字起こし読み込み:書式を保てるDOCX形式がすすめられています。マニュアルの例も、発話ごとに段落を分け、行頭に話者記号とコロンを置く形です。文字起こしソフトから書き出すときは、話者とタイムスタンプの両方を含める設定にするよう案内されています。タイムスタンプがあれば、MAXQDA上で該当箇所の音声を再生しながら確認できます。
- ATLAS.tiのサポート形式:.docxや.txtなどのテキスト文書に対応しています。
QDAソフトに取り込んだ後の基本的な分析フローは次の通りです。
- 逐語録ファイルの読み込み:DOCXまたはTXTを取り込み、文書として登録します。
- コード(ノード)の作成:研究課題や分析視点に基づき、コード体系を立ち上げます。
- セグメントへのコード付与:逐語録を読み込みながら、意味のある文脈ごとに発話範囲を選択してコードを割り当てます。
- 検索と引用の抽出:同じコードが付いた発話を一覧で比較・検討し、概念の共通点や差異を整理して論文に載せる引用文を抽出します。
修正版グラウンデッド・セオリー・アプローチ(M-GTA)、SCAT(Steps for Coding and Theorization)、主題分析(テーマ分析)など、どの質的分析手法を採用する場合でも、発話構造が整った逐語録を用意することが信頼性の高い分析への第一歩です。
よくある質問
逐語録はすべて一字一句書き起こす必要がありますか?
研究の手法によって異なります。会話分析など発話構造そのものを扱う場合は言い直しや相槌も含めた厳密な文字起こしが必要ですが、テーマ分析や内容分析では文脈を変えない範囲でフィラーを除去したケバ取り形式が一般的です。
インタビュー1件の逐語録作成にはどのくらい時間がかかりますか?
録音時間、発言者の人数、音質の良し悪し、求める文字起こしのレベル(素起こしかケバ取りか)によって大きく変動します。AI文字起こしツールを使うことで文字を入力する時間は大幅に短縮されますが、録音を聞き直して内容を確認する時間は必ず確保する必要があります。
論文に載せる引用はAIの文字起こしのままで大丈夫ですか?
AIの出力したテキストをそのまま論文に引用するのは避けてください。AIが言葉を聞き間違えていたり、細かい助詞が抜け落ちていたりする可能性があるため、論文で言及する引用箇所は必ず録音と照合して一字一句確認する必要があります。
英語のインタビューも逐語録にできますか?
可能です。言語設定を英語に指定して文字起こしを行います。Subananaは日本語や英語を含む95以上の言語に対応しています。
無料で逐語録を作れますか?
書き出しまで無料で行うことはできません。無料プランでは月3回までアップロードして各ファイル15分までをプレビューでき、逐語録ファイルの書き出しには有料プランが必要です。
質的研究のインタビューデータは、丁寧に整えることで初めて分析に耐えうる価値ある資料になります。文字起こしツールをうまく組み合わせて作業を効率化し、より深い考察やコーディングに研究の時間を使ってください。