
Eén interview uitschrijven is meestal geen probleem: je zet het gesprek in een transcriptietool, leest de tekst na en bent klaar. Het wordt anders zodra je voor een scriptie, onderzoeksrapport of longread meerdere interviews moet uitschrijven: vijf respondenten, tien experts, twintig gebruikersinterviews. Dan speelt er iets dat bij één interview niet opvalt: dezelfde namen, vaktermen en afkortingen moeten door alle transcripten heen consistent gespeld worden, anders wordt coderen en citeren in de analysefase een chaos van varianten.
Deze gids richt zich specifiek op die reeks: hoe je meerdere interviews voor hetzelfde onderzoek of artikel efficiënt en consistent uitschrijft. Heb je nog maar één gesprek, lees dan eerst Interview transcriberen: stap voor stap naar een citeerbaar transcript, die gids gaat dieper in op een enkel interview van opname tot citeerbaar transcript.
Waarom meerdere interviews uitschrijven een ander probleem is dan één
Bij kwalitatief onderzoek, denk aan een scriptie met acht diepte-interviews of een artikel gebaseerd op vijf expertgesprekken, draait de analyse vaak om het vergelijken van antwoorden tussen respondenten. Dat vergelijken werkt alleen als de transcripten dezelfde schrijfwijzen hanteren:
- Namen en functies van geïnterviewden, organisaties en projecten moeten in elk transcript identiek gespeld zijn. Anders vindt je zoekfunctie of codeerschema "Van der Berg" in transcript 3 niet terug als transcript 7 het "van den Berg" schrijft.
- Vaktermen en afkortingen uit het onderzoeksdomein (bijvoorbeeld sector-specifieke termen) moeten hetzelfde terugkomen, anders splitst je codeerschema onbedoeld één begrip in twee varianten.
- Sprekersherkenning moet per interview kloppen, zeker bij interviews met meer dan één gesprekspartner (bijvoorbeeld een interviewer plus twee respondenten in een duo-interview).
Schrijf je de interviews los van elkaar uit, zonder gedeelde basis, dan ontstaat die inconsistentie vanzelf. Vooral als je de interviews over meerdere weken uitschrijft en simpelweg vergeet hoe je een naam de vorige keer schreef.
In vier stappen: een reeks interviews consistent uitschrijven
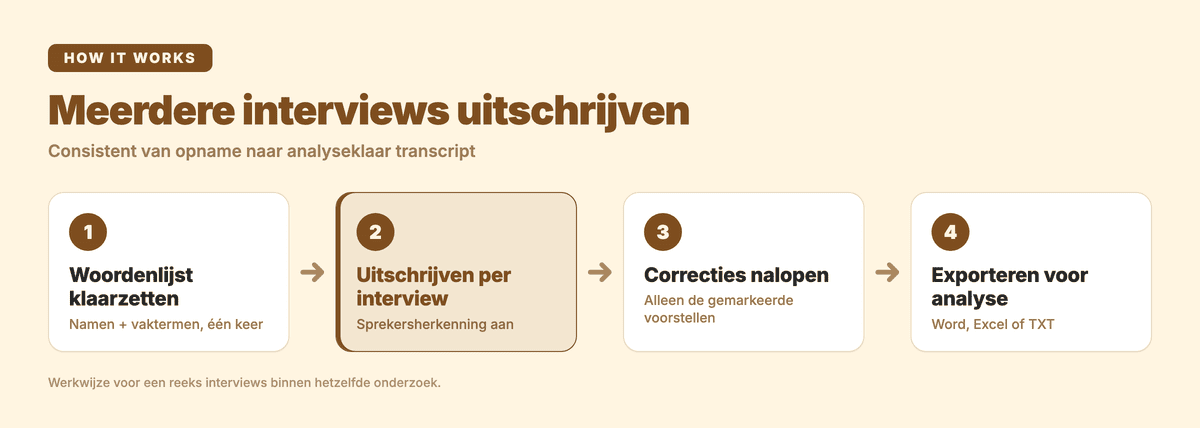
- Bouw één gedeelde woordenlijst vóór je begint. Zet namen van respondenten, organisaties en terugkerende vaktermen in een woordenlijst die je voor élk interview in de reeks gebruikt — niet per interview opnieuw. In Subanana is dit een woordenlijst voor je hele werkruimte: je zet 'm één keer klaar en de herkenningslaag past 'm toe op elk transcript dat je daarna uitschrijft, inclusief taalspecifieke schrijfwijzen waar nodig.
- Werk elk interview uit met sprekersherkenning aan. Kies de transcript-modus (niet de ondertitel-modus — die laat leestekens en alinea's expres weg, wat voor onderzoek juist onhandig is). Sprekersherkenning splitst het gesprek automatisch per spreker, en automatische interpunctie en alinea-indeling staan altijd aan bij deze modus (er is geen instelling om ze uit te zetten).
- Loop de correctievoorstellen na, niet de hele tekst blind. In plaats van elk transcript van voor naar achter te herlezen, controleer je de gemarkeerde correctievoorstellen (meestal verkeerd verstane woorden of homofonen) en klik je akkoord of wijzig je ze. Dat is aanzienlijk sneller dan een volledige herlezing per interview, zeker bij een reeks van meer dan een paar gesprekken.
- Exporteer in het formaat dat je analysemethode nodig heeft. Voor handmatig coderen werkt een Word-bestand (DOCX) meestal het prettigst; voor kwantitatieve verwerking van metadata is Excel (XLSX) handiger. Subanana exporteert beide, naast SRT, VTT, TXT en Markdown.
Wil je binnen een transcript snel iets terugvinden, bijvoorbeeld "wat zei respondent 4 over X", dan kan dat via de AI-chat in de transcripteditor, die vragen beantwoordt op basis van dat ene transcript. Handig tijdens het uitschrijven zelf; voor het daadwerkelijke coderen en vergelijken tussen interviews blijft een kwalitatief-analysepakket (of gewoon je codeerschema in Excel) het gereedschap.
Wanneer volstaat een gratis route, en wanneer niet
Voor één kort interview is een gratis route vaak genoeg om de tekst te bekijken: de ingebouwde dictatiefunctie van Google Docs, of de gratis laag van een transcriptietool. Let bij dat laatste op wat "gratis" precies dekt. Op Subanana's gratis laag bijvoorbeeld bekijk je de eerste 15 minuten van een bestand, maar het exporteren of kopiëren van de tekst zelf is een betaalde functie. Voor één interview dat je alleen even wilt doorlezen, is dat geen probleem; bij een reeks van meerdere interviews die je moet coderen of citeren, telt die beperking meteen tien of twintig keer mee in plaats van één keer. De actuele plannen en limieten staan op de pricingpagina.
Veelgestelde vragen
Waar kan ik gratis interviews transcriberen?
Gratis opties bestaan: de dictatiefunctie in Google Docs (live meespreken, geen bestand achteraf), of de gratis laag van transcriptietools waaronder Subanana. Voor het bekijken van de tekst van één kort interview werkt dat prima. Let wel op de beperking: op Subanana's gratis laag bekijk je de eerste 15 minuten van een bestand, maar exporteren of kopiëren van de tekst is een betaalde functie. Bij een reeks van meerdere interviews die je wilt coderen of citeren, loop je daar als eerste tegenaan.
Hoe zeg je "interview" in het Nederlands?
"Interview" is zelf al een volledig ingeburgerd Nederlands woord (geleend uit het Engels) en wordt in vrijwel elke context gebruikt. Het Nederlandse alternatief is "vraaggesprek" — beide woorden zijn correct en worden door elkaar gebruikt; "interview" is in de praktijk de gangbaardere term, ook in formeel taalgebruik.
Gerelateerde gidsen
- Interview transcriberen: stap voor stap naar een citeerbaar transcript
- Live transcriptie voor evenementen: zo werkt het