Spraakherkenning is technologie die gesproken taal automatisch omzet in geschreven tekst. Je spreekt in een microfoon, een computerprogramma "luistert" mee en typt vrijwel meteen uit wat je zegt. Het zit inmiddels in dingen die je waarschijnlijk al dagelijks gebruikt: je toetsenbord, WhatsApp, Google Docs, je telefoon.
Wat is spraakherkenning?
Spraakherkenning (ook wel automatische spraakherkenning of ASR genoemd) is software die audio analyseert en er tekst van maakt. Niets meer, niets minder: het gaat om het omzetten van gesproken woorden naar geschreven woorden.
Dat is iets anders dan spraakbediening, waarbij je apparaten aanstuurt met commando's ("zet de wekker op zeven uur"). Spraakbediening gebruikt vaak spraakherkenning onder de motorkap, maar het doel is een actie, geen tekst.
Het is ook het omgekeerde van tekst-naar-spraak (text-to-speech), waarbij een computer geschreven tekst hardop voorleest. Spraakherkenning gaat van geluid naar tekst; tekst-naar-spraak gaat van tekst naar geluid. Verschillende techniek, tegenovergestelde richting.
Hoe werkt spraakherkenning in het kort?
Moderne spraakherkenning werkt met een AI-model dat is getraind op enorme hoeveelheden gesproken audio met bijbehorende tekst. Het model leert daaruit welke klanken bij welke woorden horen, in welke taal dan ook.
Als je iets inspreekt, hakt het model de audio op in kleine stukjes en voorspelt per stukje welk woord (of welke lettergreep) het meest waarschijnlijk is, gegeven wat ervoor en erna komt. Zo bouwt het een lopende zin op, inclusief interpunctie in de betere systemen.
Veel moderne modellen kennen tientallen talen, maar hoe goed ze een taal of dialect herkennen, hangt af van hoeveel voorbeelden ze daarvan tijdens de training hebben gehoord. De kwaliteit verschilt dus per taal en regio, ook al lijkt de technologie overal hetzelfde. Sommige tools gebruiken daarom intern meerdere modellen naast elkaar en kiezen per taal het best passende, in plaats van op één model te vertrouwen voor alles.
Wat bepaalt de nauwkeurigheid van spraakherkenning?
Een paar factoren maken het verschil tussen een transcript dat je zo kan gebruiken en een transcript vol foutjes:
- Geluidskwaliteit. Achtergrondgeluid, een matige microfoon of een galmende ruimte maken het voor elk model moeilijker om woorden goed te onderscheiden.
- Accenten en dialecten. Modellen presteren het best op de spraak die ze het meest hebben gezien tijdens training. Vlaams klinkt anders dan Nederlands-Nederlands, dus een model dat vooral het ene heeft gehoord, kan meer moeite hebben met een uitgesproken accent uit het andere.
- Meerdere sprekers door elkaar. Als mensen elkaar onderbreken of overlappen, moet het model niet alleen woorden herkennen maar ook uitzoeken wie wat zegt. Dat is een stuk lastiger dan één spreker die rustig dicteert.
- Vakjargon en namen. Onbekende eigennamen, merknamen of technische termen worden sneller verkeerd geraden, simpelweg omdat het model ze minder vaak is tegengekomen.
Een peer-reviewed onderzoek naar OpenAI's Whisper-model (Graham & Roll, JASA Express Letters, 2024) bevestigt dat patroon: Amerikaans-Engels werd beter herkend dan Brits- en Australisch-Engels, en moedertaalsprekers werden gemiddeld nauwkeuriger herkend dan sprekers van Engels als tweede taal. Ook las het model voorgelezen tekst beter dan spontaan, informeel gesproken taal. Het onderzoek ging over Engels, maar de les is algemeen: hoe verder je spraak afwijkt van wat een model gewend is, hoe groter de kans op fouten. Dat maakt het aannemelijk dat ook Vlaams en Nederlands-Nederlands niet altijd even goed herkend worden.
Je kan dit deels zelf beïnvloeden. Spreek dicht bij de microfoon, beperk achtergrondgeluid waar mogelijk, en geef een tool waar dat kan vooraf de lastige namen en vaktermen mee. Die twee dingen heb je zelf in de hand, welk model er ook onder de motorkap draait.
Waar kom je spraakherkenning tegen?
Spraakherkenning zit inmiddels overal, vaak zonder dat je er expliciet bij stilstaat:
- Dicteren in Word. Microsoft Word heeft een ingebouwde dicteerfunctie waarmee je rechtstreeks in je document kan inspreken. Hoe je dat instelt en wat de beperkingen zijn, lees je in dicteren in Word.
- Google Docs spraak-naar-tekst. Ook Google Docs kan meeschrijven terwijl je praat, rechtstreeks in de browser. Zie Google Docs spraak-naar-tekst voor de details.
- WhatsApp spraakberichten. WhatsApp kan spraakberichten omzetten in tekst, handig als je een bericht niet kunt afspelen. Hoe dat precies werkt, staat in WhatsApp spraak naar tekst.
- Vergaderingen en meeting-transcriptie. Van teamoverleg tot klantgesprek: spraakherkenning maakt van een opname een doorzoekbare tekst, vaak met wie wat heeft gezegd. Wil je zelf eerst een vergadering opnemen voordat je hem laat uitschrijven, dan lees je dat in vergadering opnemen.
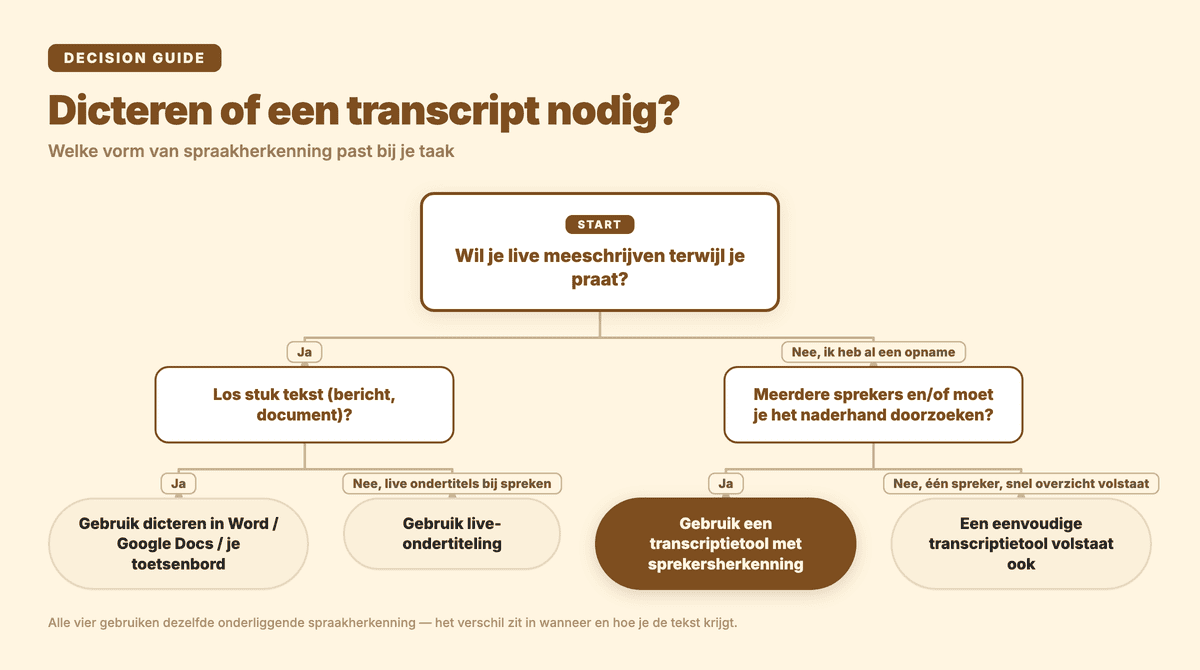
Al deze toepassingen gebruiken dezelfde onderliggende technologie, maar met een ander doel. Dicteren is spraakherkenning in het moment, bedoeld om snel een los stuk tekst te typen. Voor een hele opname, zoals een vergadering, interview of podcast, wil je meestal iets anders: een compleet transcript dat je achteraf kan doorzoeken, bewerken en delen, inclusief wie wat heeft gezegd.
Spraakherkenning voor een transcript of notulen
Daar ligt het verschil met een gespecialiseerde transcriptietool. Zo'n tool neemt een audio- of video-opname, herkent wie er spreekt en levert een uitgeschreven, doorzoekbare tekst op in plaats van live meegetypte zinnen. Die sprekersherkenning is precies waar losse dicteerfuncties niet voor gebouwd zijn, zoals uitgelegd in sprekersherkenning in een transcript. Voor notulen scheelt dat een berg handwerk: geen woord-voor-woord uittypen meer, wel een tekst waarin je kan zoeken op wie wanneer wat zei.
Subanana is zo'n tool: je uploadt of neemt een gesprek op, en krijgt een transcript terug met sprekerslabels. Namen, merknamen en vakjargon, de foutbron die hierboven al terugkwam, kan je vooraf vastzetten in een woordenlijst, zodat ze correct gespeld worden in plaats van steeds anders verkeerd geraden. Met een betaald abonnement exporteer je het resultaat naar SRT, VTT, TXT, DOCX, XLSX of Markdown, voor verslag, ondertiteling of archief. Probeer de AI-transcriptietool op je eigen opname.
Veelgestelde vragen
Hoe kan ik praten omzetten naar tekst? Via een spraakherkenningsfunctie op je toestel (bijvoorbeeld het dicteertoetsenbord op telefoon of de dicteerfunctie in Word of Google Docs) voor losse zinnen, of via een transcriptietool zoals Subanana als je een hele opname wil omzetten naar een doorzoekbaar transcript.
Hoe zet ik spraakherkenning uit? Dat verschilt per platform, maar meestal vind je de instelling terug in de systeeminstellingen van je toetsenbord of besturingssysteem, onder een kopje als "spraak" of "dicteren". Op Windows vind je het bij de spraak- of toegankelijkheidsinstellingen, op Android meestal in de instellingen van je toetsenbord. Zoek in de instellingen op "spraak" als je het niet meteen ziet.
Hoe kan ik tekst omzetten naar spraak? Dat is het omgekeerde proces, tekst-naar-spraak (text-to-speech) genoemd, en dus geen spraakherkenning. De meeste besturingssystemen en veel apps hebben daar een ingebouwde voorleesfunctie voor.
Wat is de beste gratis transcriptiesoftware? Dat hangt af van je taal, de lengte van je opname en of je sprekersherkenning nodig hebt. In beste transcriptiesoftware zetten we de opties op een rij, inclusief wat je gratis kan doen en waar je tegen limieten aanloopt.
Spraakherkenning is inmiddels goed genoeg om als eerste versie te vertrouwen, zolang je weet waar het op struikelt: rommelige audio, een sterk accent dat het model weinig heeft gehoord, door elkaar pratende sprekers en onbekende namen. Om losse zinnen te dicteren volstaat de ingebouwde functie in je toetsenbord of tekstverwerker. Wil je een hele opname omgezet krijgen tot een doorzoekbaar transcript met sprekerslabels, dan is dat precies waar Subanana voor gebouwd is.